

Robots.txt uitgelegd: wat is het en hoe gebruik je het voor SEO?

Een robots.txt-bestand is klein, maar kan een grote invloed hebben op hoe zoekmachines je website bezoeken. Met enkele regels geef je crawlers instructies over welke delen van je website ze mogen bekijken en welke ze beter overslaan.
Dat klinkt eenvoudig, maar robots.txt wordt regelmatig verkeerd begrepen. Zo denken veel website-eigenaren dat je met dit bestand pagina’s uit Google kunt verwijderen. Of dat een geblokkeerde map automatisch beschermd is tegen ongewenste bezoekers. Geen van beide klopt.
Wat doet robots.txt dan wel? Wanneer is het nuttig voor SEO? En hoe zit het tegenwoordig met AI-crawlers zoals GPTBot? We leggen uit hoe het werkt, welke instellingen belangrijk zijn en welke fouten je beter vermijdt.
Wat is robots.txt?
Robots.txt is een tekstbestand dat instructies bevat voor automatische programma’s die websites bezoeken. Zulke programma’s noemen we crawlers of bots. Zoekmachines zoals Google gebruiken ze om webpagina’s te ontdekken, inhoud te analyseren en wijzigingen op websites op te merken.
Het bestand bevindt zich op een vaste plaats: rechtstreeks achter de domeinnaam van je website.
https://theotherconcept.be/robots.txt
Wanneer een crawler je website wil bezoeken, kan die eerst het robots.txt-bestand raadplegen. Daarin staat bijvoorbeeld dat bepaalde mappen niet gecrawld mogen worden of dat een specifieke bot andere regels moet volgen.
Je kunt robots.txt vergelijken met een bord aan de ingang van een gebouw. Het vertelt bezoekers welke ruimtes toegankelijk zijn en welke niet. Alleen is er een belangrijk verschil: robots.txt is een verzameling instructies, geen afgesloten deur. Betrouwbare zoekmachinecrawlers respecteren die instructies, maar niet iedere bot doet dat.
Waarom bestaat robots.txt eigenlijk?
Toen zoekmachines het internet begonnen te doorzoeken, ontstond de behoefte om websitebeheerders enige controle te geven over automatische bezoeken. In 1994 werd daarvoor het Robots Exclusion Protocol geïntroduceerd.
Het principe was eenvoudig: één publiek toegankelijk bestand waarin website-eigenaren konden aangeven welke delen van hun website crawlers beter niet bezoeken.
In 2022 werd dit protocol formeel vastgelegd in RFC 9309. De basisgedachte is al die jaren grotendeels hetzelfde gebleven, maar het aantal toepassingen en soorten crawlers is sterk gegroeid.
Hoe werkt een robots.txt-bestand?
Een robots.txt-bestand bestaat uit eenvoudige tekstregels. Je hebt er geen ingewikkelde programmeertaal voor nodig.
Een basisvoorbeeld ziet er zo uit:
User-agent: *
Disallow: /private/
Sitemap: https://www.jouwdomein.be/sitemap_index.xml
Deze regels betekenen het volgende:
- User-agent: * – De instructies gelden voor alle crawlers die deze regels ondersteunen.
- Disallow: /private/ – Crawlers krijgen de instructie om URL’s onder deze map niet te bezoeken.
- Sitemap: – Verwijst naar de XML-sitemap van de website.
De meeste websites hebben geen bijzonder uitgebreid robots.txt-bestand nodig. Vaak volstaan enkele regels om ongewenste crawlactiviteiten te beperken en zoekmachines naar de sitemap te verwijzen.

De belangrijkste robots.txt-richtlijnen
| Richtlijn | Functie |
|---|---|
User-agent |
Bepaalt op welke crawler een groep regels van toepassing is. |
Disallow |
Geeft aan welke URL-paden niet gecrawld mogen worden. |
Allow |
Maakt het mogelijk om uitzonderingen toe te staan binnen een bredere blokkade. |
Sitemap |
Verwijst naar de locatie van een XML-sitemap. |
# |
Wordt gebruikt om commentaar toe te voegen aan het bestand. |
Met User-agent: * richt je je tot alle crawlers. Wil je specifiek instructies geven aan Googlebot, dan kun je een aparte groep maken.
User-agent: Googlebot
Disallow: /voorbeeldmap/
Je kunt ook verschillende groepen combineren. Houd er wel rekening mee dat crawlers regels op hun eigen manier kunnen ondersteunen en interpreteren. Een regel die bij Google werkt, hoeft niet automatisch hetzelfde effect te hebben bij iedere andere bot.
Wat betekenen het sterretje en het dollarteken?
Bij Google kun je in URL-patronen ook speciale tekens gebruiken.
Het sterretje * kan overeenkomen met een willekeurige reeks tekens. Het dollarteken $ markeert het einde van een URL.
Bijvoorbeeld:
User-agent: *
Disallow: /*.pdf$
Voor Googlebot betekent dit dat URL’s die eindigen op .pdf niet gecrawld mogen worden.
Dat kan in specifieke situaties nuttig zijn, maar het is geen standaardregel die je zomaar op iedere website moet toepassen. Misschien wil je net dat bepaalde PDF-documenten via Google gevonden worden.
Een andere richtlijn die je soms tegenkomt, is Crawl-delay. Sommige crawlers ondersteunen die, maar Googlebot houdt geen rekening met Crawl-delay in robots.txt.
Robots.txt is niet hetzelfde als noindex
Dit is waarschijnlijk het belangrijkste onderscheid in het volledige artikel.
Robots.txt regelt welke URL’s een crawler mag bezoeken. Noindex geeft aan dat een pagina niet in de zoekresultaten mag worden opgenomen.
Dat lijkt misschien op hetzelfde neer te komen, maar technisch zijn het twee verschillende zaken.
Stel dat je een pagina hebt die niet in Google mag verschijnen. Je voegt de volgende regel toe:
User-agent: *
Disallow: /verborgen-pagina/
Google krijgt nu de instructie om die pagina niet te crawlen. Maar dat betekent niet noodzakelijk dat de URL uit de zoekresultaten verdwijnt.
Wanneer andere websites naar die URL linken, kan Google het bestaan ervan nog steeds ontdekken. De URL kan dan onder bepaalde omstandigheden in de zoekresultaten verschijnen, zelfs zonder dat Google de inhoud heeft bezocht.
Wil je voorkomen dat een toegankelijke pagina geïndexeerd wordt, dan gebruik je doorgaans een noindex-instructie.
Waarom robots.txt en noindex elkaar kunnen tegenwerken
Een veelgemaakte fout is om dezelfde pagina zowel via robots.txt te blokkeren als een noindex-instructie mee te geven.
Het probleem? Als Google de pagina niet mag crawlen, kan Google de noindex-instructie op die pagina mogelijk niet lezen.
Daardoor bereik je net niet wat je wilde.
Wil je een pagina uit de zoekresultaten houden, dan moet Google de noindex-instructie kunnen ontdekken. Voor echt vertrouwelijke informatie is zelfs dat niet voldoende: die beveilig je met toegangscontrole, bijvoorbeeld via een wachtwoord.

En wat doet een XML-sitemap dan?
Een XML-sitemap heeft opnieuw een andere functie. Ze helpt zoekmachines belangrijke URL’s van je website te ontdekken.
Waar robots.txt bepaalde crawlactiviteiten kan beperken, geeft een sitemap juist aan welke URL’s je onder de aandacht van zoekmachines wilt brengen.
Een sitemap is geen garantie op indexering en kan een blokkade in robots.txt niet opheffen.
In ons artikel over XML-sitemaps en SEO leggen we uitgebreider uit hoe zo’n sitemap werkt en waarom een correcte samenstelling belangrijk is.
Welke pagina’s kun je beter wel of niet blokkeren?
Niet iedere URL op een website is even belangrijk voor zoekmachines.
Een website kan bijvoorbeeld interne zoekresultaten, filtercombinaties, tijdelijke URL’s of technische onderdelen bevatten die weinig waarde hebben als afzonderlijke zoekresultaten.
Voor sommige van die URL’s kan het nuttig zijn om crawling te beperken. Maar dat betekent niet dat je ze allemaal automatisch in robots.txt moet blokkeren.
Wanneer kan een blokkade nuttig zijn?
Denk aan een grote webshop met honderden productfilters. Eén categorie kan via combinaties van kleur, maat, merk en prijs duizenden verschillende URL’s opleveren.
Wanneer zoekmachines al die varianten proberen te bezoeken, kan dat onnodige crawlactiviteit veroorzaken.
In zo’n situatie kan robots.txt onderdeel zijn van een bredere technische SEO-aanpak. Je moet dan wel rekening houden met de vraag of bepaalde filterpagina’s misschien juist relevant zijn voor organisch zoekverkeer.
Ook technische mappen of interne zoekresultaten kunnen kandidaten zijn, afhankelijk van hoe de website is opgebouwd.
Wat blokkeer je doorgaans beter niet?
Belangrijke dienstenpagina’s, productpagina’s, categoriepagina’s en blogartikelen moeten normaal toegankelijk blijven voor zoekmachines.
Hetzelfde geldt voor CSS- en JavaScript-bestanden die nodig zijn om je website correct weer te geven. Google probeert pagina’s namelijk ook te begrijpen zoals een bezoeker ze ziet.
Als je essentiële bestanden blokkeert, kan dat de manier waarop Google je pagina interpreteert negatief beïnvloeden.
Let ook op met het blokkeren van afbeeldingen. Wanneer je wilt dat productfoto’s of andere beelden via Google Afbeeldingen gevonden worden, is het doorgaans niet verstandig om hun bestanden voor Googlebot-Image af te schermen.
Robots.txt instellen in WordPress
Gebruik je WordPress? Dan hoef je niet noodzakelijk zelf een robots.txt-bestand aan te maken.
WordPress kan standaard een virtueel robots.txt-bestand aanbieden. Dat betekent dat de inhoud dynamisch wordt weergegeven, ook wanneer er geen fysiek bestand in de hoofdmap van je hosting staat.
Een veelvoorkomend voorbeeld voor WordPress is:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://www.jouwdomein.be/sitemap_index.xml
Hiermee wordt de WordPress-beheermap voor crawlers geblokkeerd, met een uitzondering voor het bestand admin-ajax.php.
De sitemap-URL is slechts een voorbeeld. Welke URL je gebruikt, hangt af van de sitemap die jouw website daadwerkelijk aanbiedt.
Kun je robots.txt aanpassen met Yoast SEO?
Bij WordPress zijn er verschillende manieren om robots.txt te beheren. Afhankelijk van je configuratie kun je hiervoor een SEO-plugin, een bestandsbeheerder of een FTP-verbinding gebruiken.
Yoast SEO biedt in bepaalde configuraties een bestandseditor waarmee je robots.txt kunt aanmaken of aanpassen. De beschikbaarheid daarvan hangt onder meer af van je WordPress- en serverinstellingen.
Werk je met een fysiek robots.txt-bestand, dan heeft dat doorgaans voorrang op het virtuele bestand van WordPress.
Pas robots.txt nooit zomaar aan omdat een online voorbeeld beweert dat bepaalde regels je SEO-score verbeteren. De juiste instellingen hangen af van je website, je technische opbouw en de URL’s die je wilt laten crawlen.
En wat met WooCommerce?
Bij WooCommerce komen er extra aandachtspunten bij.
Een webshop heeft vaak een winkelmandje, afrekenpagina, klantaccount, productfilters en interne zoekresultaten. Sommige van die URL’s hoeven niet in Google te verschijnen.
Toch is robots.txt niet automatisch de beste oplossing om ze uit de zoekresultaten te houden. Voor bepaalde pagina’s is noindex geschikter, terwijl je voor filter- en parameter-URL’s ook moet kijken naar canonical-tags, interne links en de structuur van de webshop.
Een goede WooCommerce-configuratie is dus meer dan een lijstje mappen blokkeren.

Veelgemaakte fouten met robots.txt
Een verkeerd robots.txt-bestand kan belangrijke delen van je website ontoegankelijk maken voor zoekmachines. Daarom is het verstandig om wijzigingen altijd zorgvuldig te controleren.
Per ongeluk je volledige website blokkeren
De bekendste fout is deze:
User-agent: *
Disallow: /
Deze regels geven alle crawlers die ze respecteren de instructie om geen enkele URL van de website te crawlen.
Zo’n instelling kan bewust worden gebruikt tijdens de ontwikkeling van een website. Maar wanneer ze na de lancering blijft staan, kan dat grote gevolgen hebben voor de organische vindbaarheid.
Een bestaande indexering verdwijnt daardoor niet noodzakelijk onmiddellijk, maar zoekmachines kunnen de inhoud niet meer normaal opnieuw crawlen.
Robots.txt gebruiken als beveiliging
Een robots.txt-bestand is publiek toegankelijk. Iedereen kan het openen en zien welke paden je erin vermeldt.
Het is daarom geen geschikte plaats om gevoelige URL’s te verbergen.
Een regel zoals Disallow: /vertrouwelijke-documenten/ verhindert niet dat iemand die het adres kent de bestanden rechtstreeks probeert te openen.
Voor vertrouwelijke informatie gebruik je echte beveiliging, zoals authenticatie en correcte toegangsrechten.
Verkeerde paden of onnodige blokkades
Robots.txt werkt met URL-paden. Een kleine fout kan ervoor zorgen dat een regel meer of minder blokkeert dan je bedoelde.
Ook een robots.txt-bestand op de verkeerde locatie werkt niet zoals verwacht. Het bestand hoort in de hoofdmap van de betreffende host en geldt niet automatisch voor andere subdomeinen.
Controleer daarom altijd het uiteindelijke effect van je regels, niet alleen of het bestand technisch bestaat.
Robots.txt en AI-crawlers: kun je AI-bots blokkeren?
Robots.txt krijgt tegenwoordig een extra dimensie door de opkomst van generatieve AI.
Naast traditionele zoekmachinecrawlers bezoeken ook AI-gerelateerde systemen websites. Sommige verzamelen informatie die mogelijk wordt gebruikt voor modeltraining, terwijl andere websites bezoeken om informatie voor zoek- en antwoordfuncties te verzamelen.
Die toepassingen zijn niet allemaal hetzelfde. Daarom is het belangrijk om te begrijpen welke crawler je precies aanstuurt.
Wat is het verschil tussen GPTBot en OAI-SearchBot?
OpenAI maakt onder meer onderscheid tussen twee crawlers.
GPTBot wordt gebruikt om inhoud te crawlen die mogelijk kan bijdragen aan de training van generatieve AI-modellen.
OAI-SearchBot wordt gebruikt voor zoekfuncties van ChatGPT. Deze crawler helpt websites vindbaar te maken binnen de zoekresultaten van ChatGPT.
Je kunt voor beide afzonderlijke robots.txt-instructies instellen.
Stel dat je crawling voor mogelijke modeltraining wilt beperken, maar wel gevonden wilt kunnen worden via ChatGPT Search. Dan kan een configuratie er bijvoorbeeld zo uitzien:
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /
Hiermee geef je GPTBot de instructie om je website niet te crawlen, terwijl OAI-SearchBot toegang krijgt.
Dat is geen garantie dat je website daadwerkelijk in ChatGPT-antwoorden verschijnt. Het betekent alleen dat je die specifieke zoekcrawler niet via robots.txt blokkeert.
OpenAI gebruikt daarnaast ChatGPT-User voor bepaalde bezoeken die door een gebruiker worden gestart. Omdat dit geen gewone automatische zoekcrawler is, kunnen robots.txt-regels daar anders op van toepassing zijn.
De actuele verschillen staan beschreven in de officiële documentatie over OpenAI-crawlers.
En hoe zit het met Google-Extended?
Google heeft met Google-Extended een afzonderlijk controlemechanisme waarmee websitebeheerders bepaalde toepassingen van hun inhoud voor Google’s generatieve AI-systemen kunnen beperken.
Google-Extended is geen afzonderlijke crawler die zelfstandig je website bezoekt, maar een controletoken dat via robots.txt gebruikt wordt.
Belangrijk: Google-Extended blokkeren is niet hetzelfde als Googlebot blokkeren. Het betekent ook niet dat je pagina’s automatisch verdwijnen uit AI Overviews of andere AI-functies binnen Google Search.
Voor de AI-functies van Google Search blijven de gewone zoek- en previewinstellingen relevant. Denk bijvoorbeeld aan noindex, nosnippet en andere ondersteunde previewbeperkingen.

Wat is het verschil tussen robots.txt en llms.txt?
Door de opkomst van AI wordt ook steeds vaker gesproken over llms.txt.
Hoewel de bestandsnamen op elkaar lijken, hebben ze een ander doel.
Robots.txt is een gevestigde standaard voor het aansturen van crawlers. Llms.txt is een voorstel om AI-systemen een gestructureerd overzicht van relevante website-inhoud aan te bieden.
Het is dus geen vervanging voor robots.txt en biedt niet dezelfde controle over crawling.
In ons artikel llms.txt: nuttig voor AI-vindbaarheid of vooral hype? bekijken we wat dat bestand precies belooft en welke beperkingen er vandaag nog zijn.
Hoe controleer je of je robots.txt correct werkt?
Je hoeft geen programmeur te zijn om de basis van je robots.txt te controleren.
Begin door je domeinnaam te openen met /robots.txt erachter. Verschijnt er een tekstbestand, dan kun je de regels rechtstreeks bekijken.
Controleer vervolgens of er geen algemene blokkade staat die je volledige website uitsluit. Kijk ook of belangrijke onderdelen, zoals je dienstenpagina’s, blogartikelen en productpagina’s, toegankelijk blijven.
Voor een meer gerichte controle kun je gebruikmaken van Google Search Console.
Met de URL-inspectietool kun je onderzoeken of Google een specifieke pagina mag crawlen en welke indexeringsinformatie beschikbaar is. Daarnaast biedt Search Console informatie over de robots.txt-bestanden die Google voor je website heeft opgehaald.
De officiële robots.txt-documentatie van Google is een goede referentie wanneer je twijfelt over de werking van een bepaalde regel.
Controleer ook wat er na een wijziging gebeurt
Een robots.txt-aanpassing heeft niet noodzakelijk onmiddellijk effect. Zoekmachines bewaren het bestand tijdelijk en moeten gewijzigde regels opnieuw ophalen en verwerken.
Daarom is het verstandig om na een aanpassing belangrijke URL’s te controleren en eventuele crawlproblemen op te volgen.
Wil je daarnaast de technische kwaliteit van je website onderzoeken? Met Google Lighthouse kun je onder andere prestaties, toegankelijkheid en bepaalde technische SEO-aspecten analyseren. Voor de specifieke werking van robots.txt blijft Search Console de meest gerichte keuze.
Heeft robots.txt invloed op je SEO?
Ja, maar niet op de manier die soms wordt voorgesteld.
Een robots.txt-bestand is geen rechtstreekse rankingfactor waarmee je hoger in Google verschijnt. Door een extra regel toe te voegen, stijgt je website dus niet automatisch in de zoekresultaten.
Het bestand kan wel een belangrijke rol spelen in de technische toegankelijkheid van je website.
Wanneer zoekmachines je belangrijkste pagina’s niet mogen crawlen, kunnen ze de inhoud niet normaal verwerken. Omgekeerd kan het beperken van onnodige crawlactiviteiten op grote websites helpen om beschikbare crawlcapaciteit gerichter te benutten.
Dat brengt ons bij het begrip crawlbudget.
Wat is crawlbudget?
Crawlbudget verwijst naar de hoeveelheid URL’s die een zoekmachine binnen een bepaalde periode kan en wil crawlen.
Voor een kleine bedrijfswebsite met enkele tientallen pagina’s is crawlbudget doorgaans geen groot aandachtspunt. Google kan zulke websites meestal zonder problemen bezoeken.
Bij grote webshops, nieuwssites of websites met zeer veel URL-varianten kan dat anders liggen. Daar kunnen overbodige filterpagina’s, parameters en dubbele URL’s onnodig veel crawlactiviteit veroorzaken.
Robots.txt kan dan onderdeel zijn van een bredere strategie, samen met een goede URL-structuur, interne links, canonical-tags en een verzorgde XML-sitemap.
Wie zijn website beter vindbaar wil maken, moet dus verder kijken dan één technisch bestand. In ons artikel over hoger scoren in Google bespreken we de belangrijkste SEO-principes die samen het verschil maken.
Veelgestelde vragen over robots.txt
Is een robots.txt-bestand verplicht?
Nee. Een website heeft niet verplicht een robots.txt-bestand nodig. Als er geen geldig bestand aanwezig is, kunnen zoekmachines de website doorgaans crawlen, voor zover andere technische beperkingen dat toelaten. Je gebruikt robots.txt vooral wanneer je bepaalde crawlactiviteiten bewust wilt sturen.
Kan Google een geblokkeerde pagina toch indexeren?
Ja. Een URL die via robots.txt geblokkeerd is, kan onder bepaalde omstandigheden toch in de zoekresultaten verschijnen, bijvoorbeeld wanneer andere websites ernaar linken. Google kan de inhoud dan niet normaal crawlen, maar kent mogelijk wel het bestaan van de URL.
Kan ik robots.txt gebruiken om een pagina uit Google te verwijderen?
Niet betrouwbaar. Voor een toegankelijke pagina die je niet geïndexeerd wilt hebben, gebruik je doorgaans noindex. Voor vertrouwelijke informatie is toegangsbeveiliging noodzakelijk. Robots.txt is geen vervanging voor die maatregelen.
Hoe vaak leest Google mijn robots.txt?
Google haalt robots.txt regelmatig opnieuw op en bewaart het bestand doorgaans tijdelijk in een cache. Hoe snel een wijziging wordt verwerkt, kan variëren. Ga er daarom niet van uit dat nieuwe regels onmiddellijk door iedere crawler worden toegepast.
Is robots.txt hetzelfde als llms.txt?
Nee. Robots.txt bevat instructies over crawling. Llms.txt is een voorstel om AI-systemen te helpen relevante website-inhoud te vinden en te interpreteren. Het heeft niet dezelfde status of functie als robots.txt.
Moet ik AI-crawlers blokkeren?
Dat hangt af van je doelstellingen. Wil je vooral voorkomen dat bepaalde systemen je inhoud voor modeltraining crawlen, dan kun je specifieke bots beperken. Wil je juist zo goed mogelijk gevonden worden via AI-zoekfuncties, dan moet je opletten dat je de daarvoor gebruikte crawlers niet onbedoeld blokkeert.
Een klein bestand met grote gevolgen
Robots.txt is geen magische SEO-oplossing, maar wel een belangrijk onderdeel van de technische basis van je website.
Met de juiste regels kun je zoekmachinecrawlers helpen om je website efficiënter te bezoeken. Met verkeerde regels kun je echter ook belangrijke pagina’s onbedoeld afsluiten.
Het belangrijkste is daarom niet dat je robots.txt zoveel mogelijk instructies bevat, maar dat iedere regel een duidelijke reden heeft.
Bij The Other Concept bekijken we technische SEO altijd als onderdeel van het grotere geheel. Van websitestructuur en indexering tot laadsnelheid en vindbaarheid in zoekmachines en AI-toepassingen. Want een website moet niet alleen goed ogen en vlot werken, maar ook correct ontdekt en begrepen kunnen worden.
Ontdek hoe we dat aanpakken met SEO en AI-vindbaarheid.
Laatst bijgewerkt op 8 oktober 2026.
Gerelateerde artikelen




Schema.org: wat is structured data en waarom is het belangrijk?
Een bezoeker begrijpt meestal onmiddellijk wat hij op een webpagina ziet. Een naam is een bedrijfsnaam, een bedrag is de prijs van een product en vijf sterren naast een testimonial stellen waarschijnlijk een beoordeling voor.
Voor zoekmachines ligt dat anders.
HTML vertelt vooral hoe een pagina is opgebouwd. Met Schema.org kun je extra informatie toevoegen die expliciet beschrijft wat bepaalde gegevens betekenen. Je vertelt een zoekmachine bijvoorbeeld dat iets een organisatie, persoon, artikel, product, evenement of adres is.
Die informatie noemen we structured data of gestructureerde gegevens.
Schema.org is daarmee een interessante aanvulling op technische SEO. Niet omdat enkele regels code je website plots hoger in Google plaatsen, maar omdat je machines helpt de inhoud en betekenis van je website beter te begrijpen.
Wat is Schema.org?
Schema.org is een gezamenlijke standaard voor gestructureerde gegevens op het web.
Het project werd oorspronkelijk opgericht door Google, Microsoft, Yahoo en Yandex en wordt vandaag verder ontwikkeld als een open communityproject.
Schema.org bevat een uitgebreide woordenschat waarmee je kunt beschrijven wat bepaalde informatie op een webpagina voorstelt.
Stel bijvoorbeeld dat ergens op een website staat:
The Other Concept
Voor een bezoeker kan uit de context duidelijk zijn dat dit de naam van een onderneming is. Met Schema.org kun je die betekenis expliciet maken door aan te geven dat The Other Concept een Organization of, wanneer toepasselijk, een specifieker bedrijfstype is.
Hetzelfde kun je doen met een artikel, auteur, product, vacature, evenement, recept of locatie.
Schema.org bevat daarvoor honderden verschillende types en nog veel meer eigenschappen waarmee die types verder beschreven kunnen worden.

Wat is structured data?
Schema.org en structured data worden vaak als synoniemen gebruikt, maar technisch gezien zijn ze niet helemaal hetzelfde.
Schema.org is de woordenschat.
Structured data is de manier waarop je informatie gestructureerd aan machines doorgeeft.
Je kunt het vergelijken met een taal en een zin die je met die taal schrijft.
Schema.org bepaalt bijvoorbeeld dat er een type Article bestaat en dat je daar eigenschappen zoals een titel, auteur en publicatiedatum aan kunt koppelen.
Vervolgens plaats je die informatie in een formaat dat machines kunnen lezen.
Schema.org kan onder andere gebruikt worden via Microdata, RDFa en JSON-LD. Voor veel moderne implementaties is JSON-LD bijzonder praktisch, omdat de structured data los van de zichtbare HTML kan worden opgenomen.
Hoe ziet Schema.org eruit?
Stel dat je een blogartikel publiceert met de titel Wat is Schema.org?. Met JSON-LD zou een sterk vereenvoudigd voorbeeld er ongeveer zo kunnen uitzien:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "Wat is Schema.org?",
  "author": {
    "@type": "Organization",
    "name": "The Other Concept"
  },
  "publisher": {
    "@type": "Organization",
    "name": "The Other Concept"
  }
}
</script>
Een gewone bezoeker hoeft deze code niet te zien.
Voor machines bevat ze daarentegen expliciete informatie. We vertellen onder andere dat deze pagina een blogpost bevat en dat The Other Concept eraan gekoppeld is als auteur en uitgever.
In werkelijkheid kan een implementatie uitgebreider zijn. Bij een artikel kun je bijvoorbeeld ook de publicatiedatum, wijzigingsdatum, afbeeldingen en URL van de auteur meegeven.
Google ondersteunt voor artikels onder andere de Schema.org-types Article, NewsArticle en BlogPosting.
Waarom gebruiken zoekmachines structured data?
Een zoekmachine probeert voortdurend te begrijpen wat een pagina betekent.
De woorden op de pagina, titels, interne links, afbeeldingen en algemene structuur leveren daarvoor allerlei signalen. Interne links helpen daarbij om relaties tussen pagina’s en onderwerpen zichtbaar te maken, terwijl structured data expliciete machineleesbare informatie aan de inhoud toevoegt.
Je laat daardoor een deel van de betekenis minder aan interpretatie over.
Dat betekent niet dat Google blindelings gelooft wat je in je Schema.org-code zet. De structured data moet overeenkomen met de daadwerkelijke inhoud van de pagina.
Het voordeel zit vooral in duidelijkheid.
Met de juiste structured data kan een zoekmachine bijvoorbeeld beter herkennen:
- welke organisatie bij een website hoort;
- wie een artikel geschreven heeft;
- dat een pagina over een specifiek product gaat;
- wat de prijs en beschikbaarheid van dat product zijn;
- dat bepaalde informatie een evenement of vacature beschrijft;
- hoe verschillende onderdelen van een website met elkaar samenhangen.
Die expliciete betekenis is precies waarom structured data interessant is binnen technische SEO.
Schema.org en rich results in Google
Structured data kan in bepaalde gevallen ook gebruikt worden om pagina’s in aanmerking te laten komen voor uitgebreidere zoekresultaten.
Google noemt die rich results.
Afhankelijk van het type content kan Google extra informatie uit structured data gebruiken om een zoekresultaat anders weer te geven. Denk bijvoorbeeld aan bepaalde productinformatie, recepten of evenementen.
Maar hier is een belangrijke nuance nodig:
Schema.org toevoegen betekent niet automatisch dat je een rich result krijgt.
Google bepaalt zelf welke zoekresultaten en functies worden weergegeven. Bovendien ondersteunt Google voor zoekfuncties slechts een selectie van de veel grotere Schema.org-woordenschat.
Je moet daarom onderscheid maken tussen twee dingen:
Schema.org gebruiken om informatie semantisch te beschrijven
en
structured data gebruiken die door Google voor een specifieke zoekfunctie wordt ondersteund.
Dat zijn niet noodzakelijk dezelfde zaken.
Wie structured data implementeert met een specifiek Google-resultaat als doel, controleert daarom het best de actuele Google Search Gallery met ondersteunde structured data.
Zorgt Schema.org voor hogere posities in Google?
Dit is waarschijnlijk de belangrijkste misvatting rond structured data.
Schema.org is geen knop waarmee je rechtstreeks een hogere positie in Google koopt.
Je kunt dus niet simpelweg zoveel mogelijk schema’s aan een website toevoegen en verwachten dat je daardoor boven concurrenten verschijnt.
Structured data helpt zoekmachines vooral om de informatie op een pagina explicieter te begrijpen en kan, wanneer Google het betreffende type ondersteunt, helpen om in aanmerking te komen voor bepaalde zoekfuncties.
Goede SEO blijft veel breder.
Technische kwaliteit, relevante content, interne structuur, autoriteit, gebruiksvriendelijkheid en de mate waarin een pagina aansluit bij de zoekintentie blijven allemaal belangrijk.
Zie Schema.org daarom als een extra informatielaag bovenop een website die inhoudelijk en technisch al goed in elkaar zit.
Welke Schema.org-types zijn interessant voor een bedrijfswebsite?
Welke structured data nuttig is, hangt volledig af van de website.
Een lokale onderneming heeft andere informatie dan een webshop of nieuwssite.
Toch zijn er enkele types die regelmatig relevant kunnen zijn.
Organization en LocalBusiness
Met Organization kun je informatie over een organisatie structureren.
Voor lokale bedrijven bestaan daarnaast LocalBusiness en verschillende specifiekere subtypes.
Daarbij kunnen eigenschappen worden gekoppeld zoals de naam, URL, logo, contactgegevens en andere informatie die daadwerkelijk bij de organisatie hoort.
Het doel is niet om ieder denkbaar veld in te vullen. Voeg vooral correcte informatie toe die relevant is voor de onderneming en overeenkomt met wat op de website wordt gecommuniceerd.
Article en BlogPosting
Voor artikels zoals deze kan Article of het specifiekere BlogPosting gebruikt worden.
Daarmee kun je bijvoorbeeld duidelijk maken wat de titel is, wanneer het artikel gepubliceerd en aangepast werd en wie de auteur is.
Google geeft aan dat Article structured data kan helpen om meer informatie over een artikel te begrijpen, zoals de auteur, titel, afbeeldingen en datums.
Dat maakt correcte publicatie- en wijzigingsdatums extra interessant. Zeker wanneer oudere content regelmatig wordt geactualiseerd.
Product
Voor webshops is Product een belangrijk Schema.org-type.
Je kunt daarmee productinformatie structureren en koppelen aan bijvoorbeeld een merk, SKU en aanbiedingen. Binnen een Offer kunnen vervolgens gegevens zoals prijs, valuta en beschikbaarheid worden opgenomen.
Google ondersteunt uitgebreide structured data voor producten en kan dergelijke informatie gebruiken voor verschillende productgerelateerde ervaringen in Search.
BreadcrumbList
Breadcrumbs maken duidelijk waar een pagina zich binnen de structuur van een website bevindt.
Met BreadcrumbList kan die hiërarchie ook als structured data beschreven worden.
Dat is een mooi voorbeeld van Schema.org dat aansluit bij iets wat bezoekers eveneens helpt: een logische websitestructuur.
Moet je FAQ-schema aan je FAQ toevoegen?
Hier is het belangrijk om niet met verouderd SEO-advies te werken.
Jarenlang werd aangeraden om FAQ-secties bijna standaard van FAQPage-structured data te voorzien omdat Google vragen en antwoorden uitgebreid in de zoekresultaten kon weergeven.
Dat landschap is veranderd.
Google beperkt de zichtbaarheid van FAQ-rich results sterk en geeft aan dat deze voornamelijk beschikbaar zijn voor bekende, gezaghebbende websites binnen overheid en gezondheid.
Dat betekent niet dat een FAQ op je website plots geen waarde meer heeft.
Integendeel: een goede FAQ kan bezoekers snel antwoord geven, relevante onderwerpen behandelen en een pagina inhoudelijk completer maken.
Maar FAQ-schema toevoegen puur omdat je verwacht daarmee extra ruimte in Google in te nemen, is voor een doorsnee bedrijfswebsite geen sterke strategie meer.
Dit illustreert meteen waarom structured data onderhouden moet worden: zoekmachines veranderen regelmatig welke markup ze daadwerkelijk voor zoekfuncties gebruiken.
En wat betekent Schema.org voor AI-vindbaarheid?
Hier wordt het bijzonder interessant.
Zoekmachines zijn niet langer de enige systemen die informatie op websites proberen te interpreteren. AI-zoekmachines, assistenten en andere systemen proberen eveneens te begrijpen welke bedrijven, personen, producten, diensten en onderwerpen op het web beschreven worden.
Structured data is daarbij aantrekkelijk omdat informatie expliciet en machineleesbaar wordt gemaakt.
Maar ook hier moeten we voorzichtig zijn met grote claims.
Er is geen universele regel die zegt dat het toevoegen van Schema.org ervoor zorgt dat ChatGPT, Google AI Overviews of andere AI-systemen jouw bedrijf vaker zullen noemen.
Structured data is dus geen gegarandeerde snelweg naar AI-zichtbaarheid.
Wel past het principe uitstekend binnen een bredere aanpak rond SEO en AI-vindbaarheid: zorg dat belangrijke informatie over je organisatie, diensten, auteurs en content duidelijk, consistent en technisch begrijpelijk wordt aangeboden.
Schema.org kan daar één onderdeel van zijn.
Structured data is overigens niet de enige manier waarop informatie specifiek voor machines gestructureerd kan worden aangeboden. Een recenter initiatief is llms.txt, een voorgestelde standaard die AI-agents naar belangrijke informatie en bronnen op een website kan leiden. Beide hebben een andere functie: Schema.org beschrijft de betekenis van gegevens op een pagina, terwijl llms.txt vooral als gecureerde toegangspoort tot informatie bedoeld is.

Meer Schema.org is niet automatisch beter
Wanneer mensen structured data ontdekken, ontstaat soms de neiging om zoveel mogelijk schema’s toe te voegen.
Dat is niet het doel.
Structured data moet beschrijven wat daadwerkelijk op je website aanwezig is.
Een dienst wordt geen product omdat je graag Product-schema wilt gebruiken. Een verzameling testimonials mag je niet zomaar omvormen tot structured data met fantastische ratings wanneer die markup niet aan de relevante richtlijnen voldoet.
Hetzelfde geldt voor informatie die niet zichtbaar of controleerbaar op de pagina aanwezig is.
Een goede implementatie is daarom eerder correct en doelgericht dan zo uitgebreid mogelijk.
Gebruik het meest specifieke type dat werkelijk bij de content past, vul relevante eigenschappen in en zorg ervoor dat de gegevens overeenkomen met de informatie die bezoekers zien.
Hoe voeg je Schema.org toe aan WordPress?
Wie WordPress gebruikt, hoeft niet noodzakelijk iedere regel JSON-LD zelf te schrijven.
SEO-plugins en andere gespecialiseerde plugins kunnen automatisch bepaalde structured data genereren voor onder andere websites, organisaties, personen, artikels en breadcrumbs.
Dat is handig, maar automatisering betekent niet dat je er niet meer naar hoeft te kijken.
Controleer bijvoorbeeld of de plugin de juiste organisatiegegevens gebruikt, of auteurs correct worden aangeduid en welk type aan verschillende pagina’s wordt toegekend.
Bij complexere websites kan daarnaast aangepaste structured data nodig zijn.
Let vooral op wanneer meerdere plugins tegelijk Schema.org genereren. Twee plugins kunnen dezelfde organisatie, breadcrumbs of andere informatie ieder op hun eigen manier toevoegen. Dat hoeft technisch niet altijd fout te zijn, maar kan wel tot onnodige of tegenstrijdige markup leiden.
Hoe controleer je structured data?
Na implementatie moet je structured data testen.
Daarvoor zijn twee tools bijzonder nuttig.
Google Rich Results Test
Met de Rich Results Test van Google kun je controleren of Google ondersteunde structured data op een pagina detecteert en of er problemen zijn die de geschiktheid voor rich results beïnvloeden.
De tool is vooral interessant wanneer je markup gebruikt waarvoor Google een specifieke zoekfunctie ondersteunt.
Schema.org Validator
Daarnaast bestaat de Schema.org Validator.
Deze kijkt breder naar Schema.org-markup en is daardoor ook nuttig voor types en eigenschappen die niet noodzakelijk gekoppeld zijn aan een Google rich result.
Het verschil is belangrijk.
Een Schema.org-implementatie kan technisch geldig zijn zonder dat Google daar een speciaal zoekresultaat voor aanbiedt.

Schema.org is geen SEO-truc, maar een extra informatielaag
Structured data is op zijn best wanneer je het niet als truc behandelt.
Een zoekmachine probeert te begrijpen wat je website vertelt. Schema.org geeft je een gestandaardiseerde manier om een deel van die betekenis expliciet te maken.
Je kunt aangeven dat iets een organisatie is, dat een bepaalde persoon een artikel geschreven heeft, dat een pagina een product beschrijft of dat een reeks links een breadcrumb vormt.
Dat kan zoekmachines helpen om informatie beter te interpreteren en kan voor ondersteunde contenttypes bijdragen aan uitgebreidere zoekresultaten.
Tegelijk vervangt Schema.org geen sterke content, goede websitestructuur of technische SEO.
Bij The Other Concept bekijken we structured data daarom als onderdeel van een bredere aanpak rond SEO en AI-vindbaarheid. Niet zoveel mogelijk markup toevoegen, maar de juiste informatie op een technisch correcte en begrijpelijke manier aanbieden.
Want uiteindelijk draait Schema.org om iets heel eenvoudigs: machines duidelijker vertellen wat mensen op je website vanzelf begrijpen.
Laatst bijgewerkt op 29 september 2026.
Gerelateerde artikelen


SEO woordenlijst: alle belangrijke SEO-termen uitgelegd
SEO zit vol termen en afkortingen. Van backlinks en canonical tags tot Core Web Vitals, crawling, E-E-A-T en structured data: wie zich verdiept in zoekmachineoptimalisatie krijgt al snel met behoorlijk wat vakjargon te maken.
In deze SEO woordenlijst leggen we de belangrijkste begrippen in duidelijke taal uit. Sommige termen zijn technisch, andere hebben meer te maken met content, autoriteit of de manier waarop Google zoekresultaten samenstelt.
Gebruik de alfabetische navigatie om rechtstreeks naar een letter te springen of doorloop de volledige lijst om je SEO-kennis bij te spijkeren.
Laatst bijgewerkt op 29 september 2026.
A/B-testing
Een methode waarbij twee varianten van bijvoorbeeld een pagina, titel, knop of ontwerp worden getest bij verschillende groepen bezoekers. Vervolgens wordt gemeten welke variant beter presteert voor het gekozen doel, zoals meer klikken of conversies. Bij SEO-tests moet je rekening houden met de manier waarop zoekmachines de verschillende varianten kunnen crawlen en indexeren.
Above the fold
Above the fold is het gedeelte van een webpagina dat zichtbaar is voordat een bezoeker begint te scrollen. Wat precies boven de vouwlijn verschijnt, hangt af van het schermformaat, apparaat en de gebruikte browser.
Omdat dit het eerste gedeelte is dat bezoekers te zien krijgen, plaats je hier meestal informatie die snel duidelijk maakt waar de pagina over gaat en wat iemand er kan doen. Dat betekent niet dat alle belangrijke content boven de vouwlijn moet staan: een goede pagina mag bezoekers juist uitnodigen om verder te scrollen.
In ons artikel over content boven de vouwlijn leggen we uitgebreider uit welke informatie je hier het beste plaatst en waarom dit belangrijk is voor gebruiksgemak en conversie.
Algoritme
Een algoritme is een verzameling processen en systemen waarmee een zoekmachine informatie verwerkt en resultaten selecteert. Google gebruikt veel verschillende systemen en signalen om te bepalen welke resultaten relevant zijn voor een zoekopdracht. Er bestaat dus niet één eenvoudige formule waarmee rankings worden berekend.
Alt-tekst
Alt-tekst, of alternatieve tekst, beschrijft de inhoud of functie van een afbeelding. De tekst is in de eerste plaats belangrijk voor toegankelijkheid, bijvoorbeeld voor mensen die een schermlezer gebruiken. Daarnaast kan hij zoekmachines context geven over een afbeelding.
Niet iedere afbeelding heeft een uitgebreide alt-tekst nodig. Puur decoratieve afbeeldingen kunnen bijvoorbeeld een lege alt-attribuut krijgen.
AMP
AMP staat voor Accelerated Mobile Pages. Het is een open-sourceframework waarmee lichte webpagina’s konden worden gebouwd die snel op mobiele apparaten laden. AMP speelde vroeger een grotere rol binnen Google Search. Tegenwoordig is AMP geen vereiste voor bijvoorbeeld Top Stories en is een snelle, goed gebouwde reguliere webpagina doorgaans voldoende.
Anchor tekst
De anchor tekst of ankertekst is het klikbare gedeelte van een hyperlink. Een beschrijvende anchor tekst helpt bezoekers én zoekmachines begrijpen waar de gekoppelde pagina over gaat.
Een tekst zoals meer over onze aanpak voor webdesign geeft bijvoorbeeld meer context dan alleen klik hier.
AI Overviews
AI Overviews zijn door Google gegenereerde antwoorden die bij bepaalde zoekopdrachten rechtstreeks in Google Search kunnen verschijnen. Ze combineren informatie uit verschillende bronnen en kunnen links naar websites bevatten waarmee gebruikers verder kunnen zoeken.
Voor website-eigenaars gelden hiervoor in grote lijnen dezelfde technische en inhoudelijke basisprincipes als voor traditionele organische vindbaarheid.
AI Mode
AI Mode is een AI-gestuurde zoekervaring van Google waarmee gebruikers uitgebreidere vragen kunnen stellen en vervolgvragen kunnen stellen binnen dezelfde zoekervaring. Google kan daarbij informatie uit meerdere bronnen combineren en relevante websites tonen.
Article spinning
Article spinning is het automatisch of handmatig herschrijven van bestaande content om meerdere varianten van vrijwel dezelfde tekst te produceren.
De techniek werd vroeger gebruikt om op grote schaal SEO-content te maken. Het produceren van grote hoeveelheden weinig originele content uitsluitend om zoekresultaten te beïnvloeden kan tegenwoordig onder Google’s spambeleid vallen.
Backlink
Een backlink is een link vanaf een andere website naar jouw website. Zo’n link kan zoekmachines helpen om pagina’s te ontdekken en kan een signaal zijn dat andere websites jouw content relevant of waardevol vinden.
Niet iedere backlink heeft dezelfde waarde. De relevantie en kwaliteit van de verwijzende pagina, de context waarin de link staat en de manier waarop de link tot stand kwam zijn belangrijker dan simpelweg zoveel mogelijk backlinks verzamelen.
Backlinks zijn dus één vorm van externe links. In ons artikel over externe links en SEO leggen we uitgebreider uit hoe inkomende en uitgaande links werken en welke rol ze binnen SEO kunnen spelen.
Black Hat SEO
Verzamelnaam voor technieken waarmee men rankings probeert te manipuleren op manieren die ingaan tegen het spambeleid van zoekmachines. Voorbeelden zijn cloaking, verborgen tekst, linkspam en bepaalde vormen van automatisch gegenereerde content.
Bouncepercentage
Een statistiek die aangeeft welk aandeel van de bezoeken als bounce wordt beschouwd. De precieze definitie hangt af van het gebruikte analyticsplatform.
In Google Analytics 4 is het bouncepercentage het tegenovergestelde van het engagementpercentage: het percentage sessies dat niet als een engaged session wordt beschouwd.
Breadcrumbs
Breadcrumbs of broodkruimelnavigatie tonen waar een pagina zich binnen de structuur van een website bevindt.
Bijvoorbeeld:
Home → Kennis & Inzichten → SEO → SEO woordenlijst
Ze helpen bezoekers navigeren en kunnen zoekmachines meer context geven over de structuur van een website.
Broken link
Een broken link is een hyperlink waarvan de bestemming niet meer correct bereikbaar is. Dat gebeurt bijvoorbeeld wanneer een pagina verwijderd of verplaatst is zonder passende redirect, of wanneer de URL verkeerd werd ingevoerd.
Cache
Een cache bewaart tijdelijk gegevens zodat deze bij een volgend verzoek sneller beschikbaar zijn. Browsers, servers, CDN’s en cachingplugins kunnen bijvoorbeeld afbeeldingen, CSS, JavaScript of complete pagina’s tijdelijk opslaan.
Caching kan daardoor een belangrijke rol spelen bij de prestaties van een website.
Canonical URL
Een canonical URL is de URL die door een zoekmachine als representatieve versie wordt gekozen wanneer meerdere URL’s dezelfde of sterk vergelijkbare content bevatten.
Met een rel="canonical"-element kun je aangeven welke URL je voorkeur heeft. Google beschouwt dit als een sterk signaal, maar kan uiteindelijk een andere canonical kiezen wanneer andere signalen daar aanleiding toe geven.
Meer technische informatie vind je in Google’s documentatie over canonicalization.
ChatGPT
ChatGPT is een AI-assistent van OpenAI die natuurlijke taal kan begrijpen en genereren. Binnen SEO kan het onder andere worden gebruikt voor brainstormen, het structureren van content, zoekintentie analyseren, ideeën voor zoekwoorden verzamelen en ondersteuning bij technische of inhoudelijke analyses.
ChatGPT vervangt daarbij geen SEO-expertise of eigen onderzoek. Gegenereerde informatie kan onjuist, onvolledig of verouderd zijn en moet daarom kritisch gecontroleerd worden. Ook maakt het gebruik van AI content op zichzelf niet goed of slecht voor SEO: kwaliteit, originaliteit, betrouwbaarheid en de waarde voor de gebruiker blijven belangrijk.
Wil je ChatGPT concreet inzetten voor SEO? Lees dan onze uitgebreide FAQ over ChatGPT en SEO, bekijk praktische voorbeelden en use cases of lees meer over wat ChatGPT voor SEO kan betekenen.
Cloaking
Cloaking betekent dat een website zoekmachines bewust andere inhoud toont dan menselijke bezoekers met als doel zoekresultaten te manipuleren. Dit is in strijd met Google’s spambeleid.
CMS
CMS staat voor Content Management System. Het is software waarmee je de inhoud van een website kunt beheren zonder iedere pagina rechtstreeks in HTML te moeten programmeren.
WordPress is een bekend voorbeeld, maar ook Drupal, Joomla, Shopify, Squarespace en andere systemen kunnen als CMS functioneren.
Content
Content is de inhoud die via een website of ander kanaal wordt aangeboden. Dat kan tekst zijn, maar ook afbeeldingen, video’s, audio, interactieve elementen, downloads en andere informatiedragers.
Voor SEO is vooral belangrijk dat content relevant en bruikbaar is voor de doelgroep en aansluit bij de zoekintentie.
Core Web Vitals
Core Web Vitals zijn Google-metingen voor bepaalde aspecten van de gebruikerservaring van een webpagina. De huidige drie zijn:
- LCP (Largest Contentful Paint): meet hoe snel belangrijke zichtbare content geladen wordt.
- INP (Interaction to Next Paint): meet hoe responsief een pagina reageert op gebruikersinteracties.
- CLS (Cumulative Layout Shift): meet onverwachte verschuivingen van de lay-out.
Ze worden gemeten aan de hand van echte gebruikersdata en spelen mee binnen Google’s bredere beoordeling van page experience.
In ons artikel over Google Lighthouse leggen we uitgebreider uit hoe je prestaties en technische kwaliteit van een website kunt analyseren.
Crawl budget
Crawl budget beschrijft hoeveel tijd en middelen Googlebot wil en kan besteden aan het crawlen van URL’s op een website.
Voor de meeste kleine websites is crawl budget geen belangrijk probleem. Het wordt vooral relevant bij zeer grote websites, snel veranderende sites of websites met grote aantallen automatisch gegenereerde URL’s.
Crawler
Een crawler, spider of bot is software waarmee zoekmachines automatisch webpagina’s ontdekken en ophalen. Google gebruikt hiervoor onder andere Googlebot.
Links en sitemaps helpen crawlers nieuwe en gewijzigde URL’s te ontdekken.
CTA
CTA staat voor Call To Action: een element dat bezoekers aanspoort om een bepaalde actie te ondernemen. Denk aan Neem contact op, Vraag een offerte aan of Bekijk onze projecten.
Een CTA is geen specifiek SEO-element, maar speelt wel een belangrijke rol bij conversie en gebruikservaring.
CTR
CTR staat voor Click-Through Rate of doorklikpercentage. Het is het percentage vertoningen dat resulteert in een klik.
In Google Search Console wordt de organische CTR bijvoorbeeld berekend door het aantal klikken op een zoekresultaat te delen door het aantal vertoningen.
Disavow
Met Google’s Disavow Links Tool kun je Google vragen bepaalde inkomende links te negeren bij de beoordeling van je website.
De tool is bedoeld voor uitzonderlijke situaties, bijvoorbeeld wanneer er een aanzienlijk aantal onnatuurlijke links naar een website verwijst en die niet op een andere manier kunnen worden verwijderd. Voor de meeste websites is disavow niet nodig.
Domeinautoriteit
Domeinautoriteit wordt gebruikt als verzamelterm voor de veronderstelde autoriteit of kracht van een domein. Bekende SEO-tools hebben hiervoor eigen scores, zoals Domain Authority of Domain Rating.
Belangrijk: Google heeft geen publieke Domain Authority-score. Scores van externe SEO-tools zijn schattingen en mogen niet worden gezien als een Google-rankingfactor.
Duplicate content
Duplicate content ontstaat wanneer dezelfde of sterk vergelijkbare inhoud via meerdere URL’s beschikbaar is.
Dat hoeft niet automatisch een SEO-probleem of overtreding te zijn. Zoekmachines proberen in dergelijke situaties meestal een representatieve of canonical versie te bepalen.
E-E-A-T
E-E-A-T staat voor Experience, Expertise, Authoritativeness en Trustworthiness: ervaring, expertise, autoriteit en betrouwbaarheid.
Google gebruikt deze begrippen binnen zijn Search Quality Rater Guidelines om kwaliteit te beoordelen. Vooral vertrouwen staat centraal.
E-E-A-T is geen afzonderlijke SEO-score die je website van Google krijgt. Het is een concept dat helpt begrijpen welke eigenschappen hoogwaardige en betrouwbare content kan hebben.
Evergreen content
Content die gedurende lange tijd relevant blijft en niet sterk afhankelijk is van actualiteit. Handleidingen, definities en basisuitleg zijn typische voorbeelden.
Evergreen betekent niet dat content nooit bijgewerkt hoeft te worden. Ook blijvend relevante artikelen kunnen verouderde voorbeelden, links of technische informatie bevatten.
Externe link
Externe link
Een externe link verwijst van de ene website naar een pagina op een ander domein. Wanneer jij vanuit je website naar een externe bron verwijst, spreken we vanuit jouw perspectief van een uitgaande externe link. Voor de ontvangende website is diezelfde link een backlink.
Externe links kunnen bezoekers toegang geven tot aanvullende informatie, onderzoek of primaire bronnen en helpen om beweringen in je content te onderbouwen.
Meer over het verschil tussen inkomende en uitgaande links en hun betekenis voor zoekmachineoptimalisatie lees je in ons artikel over externe links en SEO.
Favicon
Een favicon is het kleine herkenningsteken van een website dat onder andere in browsertabs en Google Search kan verschijnen. Vaak is het een vereenvoudigde versie van het logo of beeldmerk.
Featured snippet
Een featured snippet is een uitgelicht zoekresultaat waarin Google een deel van de informatie van een webpagina prominent kan weergeven om snel antwoord te geven op een zoekvraag.
Google bepaalt automatisch of en wanneer content als featured snippet wordt getoond.
Google Ads
Google Ads is Google’s advertentieplatform. Adverteerders kunnen onder andere advertenties laten verschijnen bij relevante zoekopdrachten.
Google Ads behoort tot SEA en niet tot organische SEO. Betalen voor Google Ads zorgt dus niet rechtstreeks voor betere organische rankings.
Google Analytics 4 (GA4)
Google Analytics 4 is Google’s analyticsplatform waarmee interacties met websites en apps kunnen worden gemeten. Je kunt er bijvoorbeeld verkeersbronnen, paginaweergaven, gebeurtenissen en conversies analyseren.
GA4 en Google Search Console vullen elkaar aan, maar meten verschillende zaken.
Google Business Profile
Google Business Profile, vroeger Google My Business, is het bedrijfsprofiel waarmee organisaties hun aanwezigheid in onder andere Google Search en Google Maps kunnen beheren.
Je kunt er bijvoorbeeld adresgegevens, openingsuren, foto’s, diensten en andere bedrijfsinformatie beheren. Voor bedrijven met een lokale doelgroep is het een belangrijk onderdeel van lokale vindbaarheid.
Google Discover
Google Discover is een gepersonaliseerde contentfeed waarin Google gebruikers content kan tonen op basis van onder andere hun interesses en activiteit, zonder dat ze daarvoor eerst een klassieke zoekopdracht hoeven uit te voeren.
Content die geïndexeerd is door Google en voldoet aan de richtlijnen voor Discover kan automatisch in aanmerking komen. Er zijn geen speciale tags of structured data nodig om je hiervoor aan te melden. Geschiktheid betekent echter niet dat Google je content daadwerkelijk in Discover zal tonen.
Verkeer vanuit Discover kan daardoor sterk fluctueren en is minder voorspelbaar dan traditioneel zoekverkeer. In ons artikel over Google Discover leggen we uitgebreider uit hoe het werkt en hoe je content hiervoor kunt optimaliseren.
Google Keyword Planner
Keyword Planner is een onderdeel van Google Ads waarmee zoekwoorden kunnen worden onderzocht en prognoses voor advertentiecampagnes kunnen worden bekeken.
SEO-specialisten gebruiken de gegevens soms als hulpmiddel voor zoekwoordenonderzoek, hoewel de tool in de eerste plaats voor Google Ads ontwikkeld is.
Google Search Console
Google Search Console is een gratis dienst van Google waarmee website-eigenaars kunnen volgen hoe hun website in Google Search presteert.
Je vindt er onder andere gegevens over klikken, vertoningen, zoekopdrachten en indexering. Search Console bevat daarnaast hulpmiddelen om technische problemen te onderzoeken en individuele URL’s te inspecteren.
Googlebot
Googlebot is de algemene naam voor Google’s webcrawlers. Googlebot bezoekt URL’s, haalt informatie op en helpt Google nieuwe en gewijzigde webpagina’s te ontdekken.
Heading
Headings zijn HTML-elementen zoals h1, h2 en h3 waarmee titels en tussenkoppen worden aangegeven.
Ze geven een tekst een logische structuur en helpen bezoekers de inhoud snel te begrijpen. Ook zoekmachines gebruiken de inhoud en structuur van een pagina om de context ervan te begrijpen.
Headings zijn echter geen systeem waarbij simpelweg zoveel mogelijk zoekwoorden in kopteksten plaatsen automatisch betere rankings oplevert.
Hreflang
hreflang wordt gebruikt om zoekmachines te informeren over verschillende taal- of regioversies van vergelijkbare pagina’s.
Voor een Belgische website kan bijvoorbeeld onderscheid worden gemaakt tussen Nederlandse en Franse versies. Een correcte implementatie helpt Google bepalen welke versie het meest geschikt is voor een gebruiker.
HTTPS
HTTPS is de beveiligde variant van HTTP. De verbinding tussen browser en website wordt daarbij versleuteld via TLS.
HTTPS beschermt gegevens tijdens de overdracht en behoort tegenwoordig tot de technische basis van een professionele website.
Index
De index is de database waarin een zoekmachine informatie over ontdekte webpagina’s opslaat en verwerkt zodat deze in aanmerking kunnen komen voor zoekresultaten.
Een pagina die gecrawld is, wordt niet noodzakelijk ook geïndexeerd.
Indexeren
Indexeren is het proces waarbij een zoekmachine een pagina analyseert en informatie erover kan opnemen in zijn index.
Indexering is geen garantie dat de pagina voor een bepaalde zoekopdracht zal ranken.
Interne link
Een interne link verwijst van de ene pagina naar een andere pagina binnen dezelfde website. Interne links helpen bezoekers om relevante informatie te vinden en maken duidelijk hoe verschillende pagina’s inhoudelijk met elkaar verbonden zijn.
Ook voor zoekmachines zijn ze belangrijk. Ze helpen crawlers nieuwe pagina’s ontdekken en geven context over de relatie tussen verschillende onderdelen van een website. Beschrijvende anchor teksten maken daarbij duidelijker wat iemand op de gekoppelde pagina kan verwachten.
Een doordachte interne linkstructuur kan zo zowel de navigatie als de structuur van een website verbeteren. In ons artikel over interne links en SEO gaan we uitgebreider in op hoe je interne links strategisch gebruikt.
Een doordachte interne linkstructuur is daarom een belangrijk onderdeel van SEO en AI-vindbaarheid.
JavaScript SEO
JavaScript SEO gaat over het toegankelijk en begrijpelijk maken van websites die JavaScript gebruiken voor zoekmachines.
Google kan JavaScript uitvoeren, maar rendering vormt een extra stap in het proces. Belangrijke content, links, metadata en canonical-informatie moeten daarom technisch correct geïmplementeerd worden.
Google heeft hiervoor uitgebreide documentatie over JavaScript SEO.
Keyword
Een keyword of zoekwoord is een woord of combinatie van woorden waarop je content kan aansluiten.
In moderne SEO draait het niet om één zoekwoord zo vaak mogelijk te herhalen. Het gaat vooral om begrijpen welke informatie iemand zoekt en daar een relevante pagina voor aanbieden.
Keyword cannibalization
Keyword cannibalization wordt gebruikt voor situaties waarin verschillende pagina’s van dezelfde website sterk op dezelfde zoekintentie gericht zijn en daardoor mogelijk met elkaar concurreren.
Niet iedere situatie waarin twee pagina’s voor hetzelfde woord verschijnen is automatisch een probleem. Het wordt vooral relevant wanneer pagina’s vrijwel hetzelfde doel hebben en je eigenlijk één duidelijke hoofdversie wilt.
Keyword density
Keyword density geeft aan welk percentage van een tekst uit een bepaald zoekwoord bestaat.
Er bestaat geen ideaal percentage waarmee je automatisch hoger rankt. Het geforceerd herhalen van zoekwoorden kan de tekst juist onnatuurlijk maken.
Keyword stuffing
Het overmatig en onnatuurlijk herhalen van zoekwoorden met als doel rankings te beïnvloeden. Keyword stuffing kan onder Google’s spambeleid vallen en levert meestal ook een slechte leeservaring op.
Landing page
Een landing page of landingspagina is een pagina waarop bezoekers terechtkomen vanuit bijvoorbeeld een zoekresultaat, advertentie, nieuwsbrief of campagne.
Binnen SEO kan een landingspagina specifiek worden opgebouwd rond een bepaalde dienst, doelgroep, locatie of zoekintentie.
Lazy loading
Lazy loading zorgt ervoor dat bepaalde bronnen, meestal afbeeldingen of video’s, pas worden geladen wanneer ze nodig zijn of in de buurt van het zichtbare gedeelte van de pagina komen.
Correct toegepast kan dit de initiële laadtijd verbeteren. Belangrijke content bovenaan een pagina moet doorgaans niet onnodig lazy-loaded worden.
Linkbuilding
Linkbuilding is het proces waarbij geprobeerd wordt relevante links vanaf andere websites naar je eigen website te verkrijgen.
Goede links ontstaan bijvoorbeeld doordat content daadwerkelijk nuttig of vermeldenswaardig is, via samenwerkingen, PR of relevante vermeldingen. Kunstmatige links kopen of op grote schaal uitwisselen met als doel rankings te manipuleren kan tegen Google’s spambeleid ingaan.
llms.txt
Een llms.txt-bestand is een voorgesteld tekstbestand waarmee website-eigenaars informatie op hun website op een gestructureerde en eenvoudig leesbare manier kunnen aanbieden aan Large Language Models (LLM’s) en andere AI-systemen. Het bestand wordt doorgaans in de root van een website geplaatst, bijvoorbeeld example.com/llms.txt.
Het idee is vergelijkbaar met een wegwijzer: in het bestand kun je aangeven welke pagina’s of informatie op je website belangrijk zijn en AI-systemen helpen relevante content gemakkelijker te vinden en interpreteren.
Belangrijk is dat llms.txt momenteel geen algemeen ondersteunde webstandaard en geen bewezen SEO- of AI-rankingfactor is. Google geeft aan dat er geen speciaal AI-bestand nodig is om in AI Overviews of AI Mode te verschijnen. Ook voor zichtbaarheid in ChatGPT is een llms.txt-bestand geen vereiste.
Zie het daarom voorlopig als een experimentele standaard, niet als een noodzakelijke SEO-optimalisatie. Meer over llms.txt en vindbaarheid binnen generatieve zoekmachines lees je in onze FAQ over ChatGPT en SEO.
Local SEO
Local SEO of lokale SEO richt zich op vindbaarheid bij zoekopdrachten met een lokale intentie, zoals webdesigner in Herselt of restaurant in Antwerpen.
Onder andere relevante locatiepagina’s, consistente bedrijfsinformatie, een Google Business Profile en lokale bekendheid kunnen daarbij een rol spelen.
Long-tail keyword
Een long-tail keyword is een specifieke zoekopdracht die doorgaans een duidelijkere intentie heeft dan een breed zoekwoord.
In plaats van webdesign kan iemand bijvoorbeeld zoeken naar WordPress website laten maken voor architecten.
Long-tail zoekopdrachten hebben afzonderlijk vaak minder zoekvolume, maar kunnen bijzonder relevant zijn doordat de intentie specifieker is.
Meta description
Een meta description is een HTML-element waarmee je een korte beschrijving van een pagina kunt meegeven.
Google kan deze tekst gebruiken als snippet onder een zoekresultaat, maar kan ook zelf een andere passage uit de pagina selecteren wanneer die beter bij de zoekopdracht past.
Een meta description is geen directe garantie op hogere rankings, maar een duidelijke beschrijving kan wel helpen om gebruikers te laten begrijpen wat ze op de pagina kunnen verwachten.
Mobile-first indexing
Mobile-first indexing betekent dat Google hoofdzakelijk de mobiele versie van een website gebruikt voor crawling en indexering.
Daarom moet belangrijke content ook op mobiele apparaten beschikbaar zijn.
Waarom een goede mobiele ervaring breder gaat dan alleen responsive design lees je in ons artikel over mobiele optimalisatie.
Nofollow
nofollow is een waarde voor het rel-attribuut van een link. Hiermee geef je aan dat je geen normale associatie met de gelinkte pagina wilt aangeven.
Google behandelt nofollow, net als sponsored en ugc, tegenwoordig als een hint bij de verwerking van links.
Noindex
Een noindex-instructie vertelt zoekmachines dat een pagina niet in de zoekresultaten opgenomen moet worden.
Om een noindex te kunnen waarnemen, moet de crawler de pagina wel kunnen bereiken. Een URL tegelijk blokkeren via robots.txt en voorzien van noindex is daarom niet altijd de juiste aanpak.
Off-page SEO
Off-page SEO omvat activiteiten buiten de eigen website die invloed kunnen hebben op de online zichtbaarheid en reputatie van een merk of website.
Backlinks, digitale PR, vermeldingen en bepaalde lokale signalen worden vaak onder off-page SEO gerekend.
On-page SEO
On-page SEO omvat optimalisaties op de pagina zelf, zoals content, titels, interne links, afbeeldingen, headings en metadata.
Het doel is niet om zoveel mogelijk SEO-elementen af te vinken, maar om een pagina duidelijk, relevant en begrijpelijk te maken voor bezoekers en zoekmachines.
Organisch verkeer
Bezoekers die via niet-betaalde zoekresultaten op een website terechtkomen, worden doorgaans tot organisch zoekverkeer gerekend.
Page experience
Page experience beschrijft verschillende aspecten van de ervaring die bezoekers op een webpagina hebben. Denk aan snelheid, mobiel gebruiksgemak, beveiliging en opdringerige elementen.
Google benadrukt dat goede Core Web Vitals alleen niet voldoende zijn om goede rankings te garanderen. Relevante en behulpzame content blijft essentieel.
PageRank
PageRank is een systeem dat oorspronkelijk door Google werd ontwikkeld om het belang van webpagina’s mede te beoordelen op basis van links tussen pagina’s.
Google gebruikt tegenwoordig veel meer systemen en signalen dan alleen PageRank. De historische publieke PageRank-score in de Google Toolbar bestaat niet meer.
PageSpeed Insights
PageSpeed Insights is een Google-tool waarmee de prestaties van een webpagina kunnen worden onderzocht.
De tool combineert waar beschikbaar praktijkgegevens van echte gebruikers met een Lighthouse-analyse in een gecontroleerde testomgeving. Daardoor kunnen de verschillende scores en metingen van elkaar verschillen.
People-first content
People-first content is Google’s benaming voor content die in de eerste plaats voor mensen gemaakt wordt in plaats van voornamelijk om zoekmachines te manipuleren.
Goede content helpt een concrete doelgroep, toont echte kennis of ervaring en geeft de bezoeker voldoende informatie om zijn doel te bereiken.
Query
Een query is de daadwerkelijke zoekopdracht die iemand in een zoekmachine invoert.
Een keyword is het onderwerp of zoekwoord waarop je je als website-eigenaar kunt richten; de query is wat de gebruiker werkelijk intypt of inspreekt. Die twee hoeven niet exact hetzelfde te zijn.
Ranking
Ranking verwijst naar de positie waarop een webpagina voor een bepaalde zoekopdracht in de zoekresultaten verschijnt.
Een website heeft dus niet één algemene positie in Google. Rankings kunnen verschillen per zoekopdracht, locatie, taal, apparaat en andere context.
Redirect
Een redirect stuurt bezoekers en crawlers automatisch van de ene URL naar een andere.
Een permanente redirect, zoals een HTTP 301 of 308, wordt bijvoorbeeld gebruikt wanneer een pagina definitief naar een nieuwe URL verhuist. Tijdelijke redirects zoals 302 en 307 zijn bedoeld voor tijdelijke situaties.
Rich result
Een rich result is een zoekresultaat dat dankzij ondersteunde structured data extra visuele of interactieve informatie kan bevatten.
Welke rich results beschikbaar zijn, hangt af van het type content en de functies die Google op dat moment ondersteunt.
Robots.txt
robots.txt is een bestand in de root van een website waarmee crawlers instructies krijgen over welke URL’s of delen van de site ze mogen aanvragen.
Een robots.txt-bestand is in de eerste plaats bedoeld om crawling te beheren. Het is geen betrouwbare methode om een pagina uit Google’s index te verwijderen.
Schema.org
Schema.org is een gezamenlijke vocabulaire waarmee structured data kan worden beschreven. Zoekmachines kunnen deze gegevens gebruiken om explicieter te begrijpen wat bepaalde informatie op een pagina betekent.
Search intent
Search intent of zoekintentie beschrijft wat iemand met een zoekopdracht probeert te bereiken.
Iemand kan informatie zoeken, een specifieke website willen vinden, producten vergelijken of klaar zijn om een aankoop of aanvraag te doen.
Een pagina die goed aansluit bij die bedoeling is meestal nuttiger dan een pagina die alleen het exacte zoekwoord vaak vermeldt.
SEA
SEA staat voor Search Engine Advertising: betaalde advertenties binnen zoekmachines.
Google Ads is het bekendste voorbeeld. SEA en SEO kunnen elkaar aanvullen, maar betaalde advertenties verbeteren op zichzelf je organische rankings niet.
SEO
SEO staat voor Search Engine Optimization of zoekmachineoptimalisatie.
Het omvat het verbeteren van een website zodat zoekmachines de pagina’s goed kunnen vinden, begrijpen en verwerken én zodat relevante gebruikers er nuttige informatie vinden.
SEO omvat onder andere techniek, content, websitestructuur, interne links en externe signalen.
SERP
SERP staat voor Search Engine Results Page: de pagina met zoekresultaten die een zoekmachine toont na een zoekopdracht.
Een moderne SERP kan veel meer bevatten dan traditionele blauwe links, waaronder afbeeldingen, video’s, lokale resultaten, featured snippets en AI-functionaliteiten.
Sitemap
Een XML-sitemap is een bestand waarin je URL’s kunt opnemen die je belangrijk vindt voor zoekmachines. Ze helpt zoekmachines zoals Google om pagina’s te ontdekken en geeft aanvullende informatie over de structuur en wijzigingen van je website.
Een sitemap is vooral nuttig bij grotere websites, nieuwe websites met weinig externe links of websites waarbij bepaalde pagina’s moeilijker via gewone interne links bereikbaar zijn.
Het opnemen van een URL in een sitemap garandeert niet dat die pagina wordt gecrawld, geïndexeerd of hoog zal ranken. Zie een sitemap daarom als een hulpmiddel voor ontdekking, niet als een manier om indexering af te dwingen.
Hoe zo’n bestand werkt en wat je er wel en niet in moet opnemen, lees je in ons artikel over XML-sitemaps voor SEO.
Slug
De slug is het herkenbare gedeelte van een URL dat meestal een specifieke pagina aanduidt.
Bij: theotherconcept.be/seo/seo-woordenlijst/ is seo-woordenlijst de slug.
Een duidelijke, korte slug maakt een URL gemakkelijker leesbaar en beheren.
Snippet
Een snippet is de weergave van een individueel zoekresultaat. Die kan onder andere een titel, URL of sitenaam en beschrijvende tekst bevatten.
Google bepaalt uiteindelijk zelf hoe een snippet voor een specifieke zoekopdracht wordt samengesteld.
Structured data
Structured data is gestandaardiseerde informatie in de broncode waarmee je expliciet kunt aangeven wat bepaalde gegevens op een pagina voorstellen.
Google gebruikt structured data om content beter te begrijpen en om bepaalde pagina’s in aanmerking te laten komen voor rich results. Het toevoegen ervan garandeert niet dat een rich result wordt weergegeven.
Google biedt een overzicht van structured data voor Google Search.
Technical SEO
Technical SEO of technische SEO richt zich op de technische toegankelijkheid en werking van een website voor zoekmachines.
Onderwerpen zijn onder andere crawling, indexering, redirects, canonicalization, sitemaps, JavaScript, structured data en websiteprestaties.
Title tag
Het HTML-title-element geeft een webpagina een titel en is een belangrijke bron die Google kan gebruiken bij het samenstellen van de titel van een zoekresultaat.
Google kan echter een andere title link genereren wanneer het systeem vindt dat die beter bij de pagina of zoekopdracht past.
TLD
TLD staat voor Top-Level Domain en is het laatste gedeelte van een domeinnaam: het deel na de laatste punt. Bij theotherconcept.be is .be bijvoorbeeld de TLD.
Er bestaan verschillende soorten TLD’s. Landspecifieke extensies zoals .be, .nl en .fr worden ccTLD’s genoemd, terwijl generieke extensies zoals .com, .org en .design onder de gTLD’s vallen.
De gekozen TLD kan iets vertellen over de geografische doelgroep of positionering van een website, maar een bepaalde generieke extensie levert op zichzelf geen SEO-voordeel op.
Meer over de verschillende mogelijkheden en wanneer je voor .be, .com of een andere extensie kiest, lees je in ons artikel over het kiezen van een domeinnaam extensie.
URL
URL staat voor Uniform Resource Locator en is het webadres waarmee een specifieke bron op het internet bereikbaar is.
Een logische URL-structuur kan bezoekers en zoekmachines helpen begrijpen waar een pagina zich binnen een website bevindt.
User experience (UX)
User experience of gebruikerservaring beschrijft hoe iemand het gebruik van een website of digitaal product ervaart.
Navigatie, leesbaarheid, snelheid, toegankelijkheid, formulieren en mobiele bruikbaarheid spelen daar allemaal een rol in.
Vertoningen
Een vertoning of impression betekent binnen Google Search Console dat een link naar je website in een zoekresultaat aan een gebruiker is getoond volgens Google’s meetregels.
Vertoningen kunnen samen met klikken, CTR en gemiddelde positie worden gebruikt om organische zoekprestaties te analyseren.
White Hat SEO
White Hat SEO is een informele term voor SEO-methodes die niet bedoeld zijn om zoekmachines te misleiden en die binnen de richtlijnen van zoekmachines blijven.
Denk aan nuttige content, een technisch toegankelijke website, duidelijke websitestructuur en het op natuurlijke wijze verkrijgen van relevante vermeldingen en links.
WordPress
WordPress is een open-source Content Management System waarmee websites kunnen worden gebouwd en beheerd.
WordPress is op zichzelf niet automatisch goed of slecht voor SEO. Thema, techniek, content, configuratie, hosting en onderhoud bepalen uiteindelijk in grote mate hoe goed een WordPress-website technisch functioneert.
XML-sitemap
Een XML-sitemap is een lijst van alle URL’s binnen jouw website. Het is een roadmap die zoekmachines vertelt welke content beschikbaar is. Het is een belangrijk onderdeel in je SEO en ook onmisbaar in deze SEO woordenlijst.
YMYL
YMYL staat voor Your Money or Your Life. Google gebruikt deze term voor onderwerpen waarbij onjuiste informatie een aanzienlijke impact kan hebben op bijvoorbeeld iemands gezondheid, financiële situatie, veiligheid of welzijn.
Bij dergelijke onderwerpen legt Google in zijn kwaliteitsrichtlijnen extra nadruk op betrouwbaarheid.
Yoast SEO
Yoast SEO is een populaire WordPress-plugin die helpt bij het optimaliseren van je website voor zoekmachines. Het biedt tools en suggesties om de inhoud, technische instellingen en leesbaarheid van pagina’s en berichten te verbeteren, waardoor de kans groter is dat ze goed scoren in zoekresultaten.
Zoekintentie
Zoekintentie is het doel achter een zoekopdracht. Zie ook Search intent onder de letter S.
Zoekwoord
Een zoekwoord is een term of onderwerp waarop content wordt afgestemd om relevant te zijn voor bepaalde zoekopdrachten. Zie ook Keyword onder de letter K.
Zoekwoordenonderzoek
Zoekwoordenonderzoek is het onderzoeken van hoe een doelgroep naar bepaalde onderwerpen, producten, diensten of antwoorden zoekt.
Daarbij kijk je niet alleen naar zoekvolume, maar ook naar zoekintentie, relevantie, concurrentie en de relatie tussen verschillende onderwerpen.
Een goed zoekwoordenonderzoek helpt bepalen welke informatie je doelgroep nodig heeft en welke pagina’s daarvoor zinvol zijn.
We doen ons best om deze SEO woordenlijst zo relevant en actueel mogelijk te houden. Merk je toch fouten of verouderde informatie op? Laat het ons dan weten via ons contactformulier.
Gerelateerde artikelen



Hoger scoren in Google: 12 SEO-principes die blijven werken
Hoger scoren in Google is zelden het gevolg van één slimme SEO-truc. Zoekmachines gebruiken veel verschillende signalen om te bepalen welke pagina het beste antwoord geeft op een zoekopdracht.
Daarom bestaat er ook geen universele checklist waarmee iedere website automatisch op nummer één terechtkomt.
Wat wél bestaat, zijn een aantal sterke SEO-principes. Zorg dat Google je website technisch kan begrijpen, maak content die aansluit bij wat mensen zoeken, bouw duidelijke verbanden tussen pagina’s en bied bezoekers een goede ervaring.
In dit artikel bekijken we 12 SEO-principes om hoger te scoren in Google die ook blijven werken wanneer zoekmachines en AI-zoekervaringen verder evolueren.
1. Begrijp eerst waar je doelgroep naar zoekt
SEO begint niet bij Google, maar bij de persoon achter een zoekopdracht.
Welke vragen heeft die persoon? Welke woorden gebruikt hij? Wil hij informatie verzamelen, mogelijkheden vergelijken of onmiddellijk een product of dienst vinden?
Dat noemen we de zoekintentie.
Een zoekopdracht zoals wat is een warmtepomp vraagt waarschijnlijk om een informatief antwoord. Bij warmtepomp installateur Antwerpen is de behoefte heel anders.
Je kunt technisch een perfecte pagina maken, maar wanneer die niet aansluit bij wat iemand zoekt, wordt het moeilijk om sterk te presteren.
Zoekwoordenonderzoek blijft daarom nuttig. Niet omdat je een bepaalde term twintig keer in een tekst moet verwerken, maar omdat zoekwoorden inzicht geven in de taal, vragen en behoeften van je doelgroep.
Gebruik daarbij echte zoekdata uit bijvoorbeeld Google Search Console, Keyword Planner of gespecialiseerde SEO-tools en combineer die met je eigen kennis van klanten.
SEO richt zich daarbij op de organische zoekresultaten. Wil je ook betalend zichtbaar worden bij relevante zoekopdrachten, dan kom je bij SEA terecht. Beide kunnen deel uitmaken van dezelfde zoekstrategie, maar werken fundamenteel anders. In SEO vs. SEA: wat is het verschil en wanneer kies je wat? leggen we het onderscheid uitgebreider uit.
2. Maak voor iedere belangrijke zoekintentie de juiste pagina
Wanneer je weet wat mensen zoeken, moet je bepalen welke pagina daar het beste antwoord op geeft.
Dat klinkt vanzelfsprekend, maar hier loopt het vaak mis.
Een bedrijf probeert bijvoorbeeld met zijn homepage te scoren voor tien verschillende diensten. Of drie artikels behandelen bijna exact dezelfde vraag en concurreren daardoor met elkaar.
Geef belangrijke onderwerpen voldoende ruimte.
Een webdesignbureau kan bijvoorbeeld afzonderlijke pagina’s hebben voor webdesign, grafisch ontwerp en SEO. Binnen het kennisgedeelte kunnen specifieke vragen vervolgens uitgebreider behandeld worden.
Dat creëert een website waarbij iedere pagina een duidelijke functie heeft.
Kijk daarom niet alleen naar afzonderlijke zoekwoorden, maar ook naar de relatie tussen onderwerpen. Verschillende zoektermen met dezelfde intentie hoeven niet noodzakelijk allemaal een eigen pagina te krijgen.
3. Schrijf content die daadwerkelijk iets toevoegt
Er staat ondertussen bijzonder veel content online.
Met generatieve AI is het bovendien eenvoudiger dan ooit geworden om in korte tijd grote hoeveelheden tekst te produceren. Daardoor wordt één vraag alleen maar belangrijker:
Waarom zou Google juist jouw pagina tonen?
Een artikel wordt niet waardevol omdat het 2.000 woorden telt. Het wordt waardevol wanneer iemand er informatie vindt die hem daadwerkelijk verder helpt en die niet zomaar uitwisselbaar is met wat tientallen andere websites al vertellen.
Gebruik daarom waar mogelijk eigen kennis, praktijkervaring, voorbeelden, cases, foto’s, onderzoek of inzichten. Daarmee geef je een pagina iets wat moeilijker te kopiëren of automatisch samen te vatten is.
Dat principe wordt ook buiten de klassieke zoekresultaten steeds belangrijker. Google legt bij Discover expliciet nadruk op originele en diepgaande content van bronnen met kennis van het onderwerp. In ons artikel over Google Discover leggen we uit hoe content, expertise en sterke visuele elementen je kansen op zichtbaarheid in die gepersonaliseerde feed kunnen vergroten.
Meer woorden betekenen daarbij niet automatisch meer waarde. Een kort maar uitstekend antwoord kan veel nuttiger zijn dan een kunstmatig lang artikel waarin dezelfde boodschap telkens opnieuw wordt verpakt.
AI kan prima als hulpmiddel worden gebruikt om bijvoorbeeld ideeën te structureren, zoekintenties te onderzoeken of bestaande content te analyseren. Maar massaal generieke pagina’s produceren puur om zoveel mogelijk zoekopdrachten af te dekken is geen duurzame strategie. Google beschouwt grootschalige productie van weinig originele content met als hoofddoel rankings manipuleren als scaled content abuse.
Wil je weten waar AI binnen SEO wél waarde kan toevoegen? In AI gebruiken voor SEO bekijken we twaalf praktische toepassingen.
4. Laat zien wie achter de informatie zit
Goede content gaat niet alleen over wat er staat, maar soms ook over wie de informatie publiceert.
Dat is vooral belangrijk bij onderwerpen waarbij expertise, ervaring of betrouwbaarheid een grote rol spelen.
Maak daarom duidelijk wie je bent, wat je bedrijf doet en waarom je over een bepaald onderwerp kunt spreken. Gebruik auteursinformatie wanneer dat relevant is en zorg dat bezoekers gemakkelijk meer over het bedrijf of de auteur kunnen vinden.
Google gebruikt binnen zijn Search Quality Rater Guidelines het concept E-E-A-T: Experience, Expertise, Authoritativeness en Trustworthiness.
E-E-A-T is geen afzonderlijke SEO-score die je kunt verhogen door ergens een auteursvakje toe te voegen. Het concept onderstreept vooral dat betrouwbaarheid en context rond content belangrijk kunnen zijn.
Een goede over ons-pagina speelt daar ook een rol in. Niet omdat Google je automatisch punten geeft voor zo’n pagina, maar omdat je bezoekers duidelijk maakt welke organisatie en mensen achter de website zitten.
5. Bouw een duidelijke websitestructuur
Een goede website voelt logisch aan.
Vanaf de homepage kun je belangrijke diensten of categorieën bereiken. Vanuit een dienstenpagina kun je relevante verdieping vinden. Vanuit een kennisartikel kun je verder naar gerelateerde onderwerpen.
Die structuur helpt bezoekers én zoekmachines.
Google ontdekt pagina’s onder andere door links te volgen. Een belangrijke pagina die diep verstopt zit en nauwelijks interne links ontvangt, geef je daardoor weinig context en zichtbaarheid binnen je eigen website.
Denk daarom in onderwerpen en relaties.
Welke pagina is het belangrijkste overzicht? Welke pagina’s verdiepen een onderdeel? Welke artikels ondersteunen een commerciële dienst?
Zo ontstaat geen verzameling losse URL’s, maar een inhoudelijk samenhangende website.
6. Gebruik interne links bewust
Interne links zijn een van de eenvoudigste SEO-middelen waar je zelf volledige controle over hebt.
Ze helpen bezoekers om relevante informatie te ontdekken en geven zoekmachines extra context over de relatie tussen pagina’s.
Link daarom wanneer het inhoudelijk logisch is.
Als we in dit artikel bijvoorbeeld spreken over technische websitekwaliteit, kunnen we verwijzen naar ons artikel over Google Lighthouse. Een artikel over ChatGPT kan doorlinken naar een praktische toepassing van AI voor SEO.
De anchor tekst mag daarbij beschrijven wat iemand na de klik kan verwachten.
Vermijd wel dat iedere alinea vol links staat. Een interne link moet iets toevoegen voor de lezer.
In ons artikel over interne links gaan we uitgebreider in op hoe je een sterke interne linkstructuur opbouwt.
7. Zorg dat je website technisch goed in elkaar zit
Zelfs uitstekende content kan gehinderd worden door technische problemen.
Een pagina moet bereikbaar zijn voor zoekmachines, correct geïndexeerd kunnen worden en duidelijk aangeven welke versie van een URL als hoofdversie geldt. In de SEO Starter Guide van Google vind je een goed overzicht van de basisprincipes waarmee je zoekmachines helpt je website te crawlen, indexeren en begrijpen.
Denk bijvoorbeeld aan:
- crawlbaarheid en indexeerbaarheid;
- correcte canonicals;
- een logische URL-structuur;
- goede redirects bij gewijzigde URL’s;
- een XML-sitemap;
- HTTPS;
- correcte HTTP-statuscodes.
Niet ieder technisch probleem heeft dezelfde impact.
Een waarschuwing in een SEO-tool betekent niet automatisch dat er een ernstig probleem is. Kijk daarom naar de context en naar wat zoekmachines daadwerkelijk kunnen crawlen en indexeren.
Technische SEO is uiteindelijk geen wedstrijd om honderd groene vinkjes te verzamelen. Het doel is ervoor zorgen dat zoekmachines zonder onnodige obstakels bij je belangrijke content kunnen komen en die correct kunnen interpreteren.
Kom je technische termen tegen die je niet kent? In onze SEO-woordenlijst leggen we de belangrijkste begrippen afzonderlijk uit.
8. Maak je website snel én prettig om te gebruiken
Snelheid is belangrijk, maar een goede gebruikerservaring bestaat uit meer dan een snelle laadtijd.
Google kijkt bij page experience naar verschillende aspecten, waaronder Core Web Vitals, veilige verbindingen, mobiele bruikbaarheid en storende interstitials. Google benadrukt daarbij dat website-eigenaars zich niet blind moeten focussen op één afzonderlijke metriek, maar op de totale ervaring.
Een snelle website waarop bezoekers niets kunnen vinden is geen goede website.
Hetzelfde geldt voor een visueel indrukwekkende website waarbij knoppen verspringen tijdens het laden of een popup de volledige inhoud bedekt.
Met Google Lighthouse kun je onder andere performance en verschillende technische kwaliteitsaspecten controleren.
Gebruik zo’n score vooral om problemen te ontdekken. Een perfecte score is geen doel op zichzelf.
9. Vergeet mobiele bezoekers niet
Een website die op een desktop goed werkt, kan op een smartphone compleet anders aanvoelen.
Navigatie, formulieren, knoppen, tabellen, afbeeldingen en interactieve onderdelen moeten ook op een klein scherm gemakkelijk bruikbaar blijven.
Test daarom niet alleen of een layout technisch schaalt.
Probeer de website daadwerkelijk te gebruiken.
Kun je gemakkelijk navigeren? Zijn knoppen groot genoeg? Kun je formulieren comfortabel invullen? Staat belangrijke informatie niet verstopt achter onhandige interacties?
Google gebruikt bovendien de mobiele versie van een website als basis voor indexering.
Een goede mobiele ervaring is daarom geen optionele extra meer.
In mobiele optimalisatie: waarom je website niet zonder kan bekijken we uitgebreider waar je bij mobiel webdesign op moet letten.
10. Bouw autoriteit op buiten je eigen website
Je kunt op je eigen website vertellen dat je geweldig bent. Interessanter wordt het wanneer andere betrouwbare bronnen naar je verwijzen.
Backlinks spelen daarom nog steeds een rol binnen SEO.
Maar kwaliteit is belangrijker dan simpelweg zoveel mogelijk links verzamelen.
Een relevante vermelding vanuit een vakorganisatie, nieuwsmedium, leverancier, klantcase of inhoudelijk gerelateerde website kan veel waardevoller zijn dan tientallen links vanaf willekeurige websites die uitsluitend bestaan om backlinks te verkopen.
Goede links ontstaan vaak doordat er iets bestaat waarnaar het logisch is om te verwijzen.
Dat kan een sterk kennisartikel zijn, maar ook origineel onderzoek, een tool, dataset, handleiding, case of andere nuttige bron.
Vermijd technieken waarbij links uitsluitend worden gekocht of geplaatst om rankings kunstmatig te manipuleren. Google’s spambeleid bevat specifieke regels rond link spam.
11. Verbeter wat al bestaat in plaats van alleen nieuwe content te publiceren
SEO-content heeft onderhoud nodig.
Een artikel dat drie jaar geleden uitstekend was, kan ondertussen verouderde statistieken, screenshots, links of adviezen bevatten.
Dat betekent niet dat je ieder jaar de publicatiedatum moet veranderen en verder niets hoeft te doen.
Bekijk bestaande pagina’s kritisch.
Klopt de informatie nog? Zijn er nieuwe ontwikkelingen? Kunnen voorbeelden beter? Zijn er inmiddels relevante interne links? Is de zoekintentie veranderd? Kan verouderde informatie verwijderd worden?
Een grondige update kan soms veel waardevoller zijn dan alweer een nieuw artikel publiceren.
Dat is precies wat we ook met onze eigen Kennis & Inzichten doen: oudere artikels worden opnieuw beoordeeld, herschreven waar nodig en aangevuld met actuele informatie.
Bij zo’n substantiële update is het logisch om naast de oorspronkelijke publicatiedatum ook een laatst gewijzigd-datum te gebruiken. Google ondersteunt daarvoor onder andere datePublished en dateModified binnen Article structured data.
12. Meet resultaten en blijf verbeteren
SEO is geen eenmalige taak.
Nadat je een pagina hebt gepubliceerd, begint een nieuwe fase: kijken wat er gebeurt.
Google Search Console kan bijvoorbeeld laten zien voor welke zoekopdrachten een pagina verschijnt, hoeveel vertoningen en klikken ze krijgt en hoe dat doorheen de tijd verandert.
Daaruit kunnen nieuwe vragen ontstaan.
Krijgt een pagina veel vertoningen maar weinig klikken? Verschijnt ze voor zoekopdrachten waarop de inhoud onvoldoende antwoord geeft? Groeit een bepaald onderwerp? Verliest een belangrijke pagina geleidelijk verkeer?
Combineer die informatie met gegevens over wat bezoekers op de website zelf doen.
Bij belangrijke pagina’s kun je vervolgens gericht experimenteren. Met A/B-testing kun je bijvoorbeeld onderzoeken of een specifieke aanpassing invloed heeft op het gedrag van bezoekers.
SEO stopt dus niet bij gevonden worden. Uiteindelijk wil je dat de juiste bezoeker ook iets aan je website heeft.
En wat verandert AI aan deze SEO-principes?
Meer dan vroeger komt een website niet alleen in aanmerking voor klassieke zoekresultaten.
Google toont AI Overviews en AI Mode en gebruikers kunnen ook via systemen zoals ChatGPT informatie en websites ontdekken.
Dat zorgt voor nieuwe termen zoals AEO en GEO en roept vragen op over optimaliseren voor generatieve AI.
Toch is het opvallend hoeveel van de basis hetzelfde blijft.
Google heeft in 2026 expliciet verduidelijkt dat zijn bestaande SEO-best practices relevant blijven voor generatieve AI-features. Er is geen speciale AI-schema markup nodig en ook een llms.txt-bestand levert volgens Google geen ranking- of zichtbaarheidsvoordeel op binnen Search.
Wat waarschijnlijk wél belangrijker wordt, is onderscheidende informatie.
Wanneer een pagina niets meer bevat dan een generieke samenvatting van informatie die overal beschikbaar is, wordt het moeilijker om uit te leggen waarom juist die bron waardevol is.
Eigen ervaring, cases, expertise, onderzoek en concrete voorbeelden worden daardoor alleen maar interessanter.
In wat ChatGPT betekent voor SEO en online vindbaarheid gaan we dieper in op die ontwikkeling.
Hoger scoren in Google begint niet bij Google
De twaalf principes hebben uiteindelijk veel met elkaar gemeen.
Ze proberen niet een algoritme te misleiden.
Ze zorgen ervoor dat een website technisch toegankelijk is, logisch opgebouwd wordt en relevante informatie aanbiedt aan de mensen voor wie die website bedoeld is.
Dat is minder spectaculair dan een geheime SEO-truc.
Maar het is ook veel duurzamer.
Zoekmachines veranderen voortdurend. Nieuwe AI-zoekervaringen verschijnen. Rankingfactoren worden aangepast en sommige technieken verliezen hun waarde.
Een website die technisch gezond, inhoudelijk sterk, betrouwbaar en nuttig is, heeft een veel stevigere basis om met die veranderingen mee te evolueren.
Hoger scoren in Google is daarom zelden het resultaat van één optimalisatie.
Het is het gevolg van tientallen goede keuzes die samen een betere website vormen.
Laatst aangepast: 27 september 2026.
Gerelateerde artikelen

De geschiedenis van websites: van 1991 tot vandaag
De websites die we vandaag dagelijks gebruiken lijken nauwelijks nog op de eerste webpagina’s. Moderne websites bevatten video, animatie, webshops, interactieve applicaties en layouts die zich automatisch aanpassen aan vrijwel ieder scherm.
Ruim dertig jaar geleden zag het web er heel anders uit.
De eerste website bestond voornamelijk uit tekst en hyperlinks. Geen grote foto’s, geen navigatiemenu zoals we dat vandaag kennen en al helemaal geen animaties of responsive design.
Toch ligt daar de oorsprong van vrijwel alles wat we vandaag online doen.
Hoe zijn we geëvolueerd van eenvoudige HTML-documenten naar de websites en webapplicaties van vandaag? We duiken in de geschiedenis van websites en bekijken de belangrijkste momenten die webdesign gevormd hebben.
1989: het idee achter het World Wide Web
De geschiedenis van websites begint bij CERN, het Europese onderzoekscentrum voor deeltjesfysica in Zwitserland.
De Britse computerwetenschapper Tim Berners-Lee werkte er aan een manier waarop wetenschappers gemakkelijker informatie met elkaar konden delen.
In maart 1989 schreef hij een voorstel voor een systeem waarbij documenten via hypertekst met elkaar verbonden konden worden. Samen met de Belgische ingenieur Robert Cailliau werd het concept later verder uitgewerkt.
Het idee groeide uit tot wat we vandaag het World Wide Web noemen.
Belangrijk daarbij is het onderscheid tussen het internet en het web. Het internet bestond al. Het World Wide Web maakte het mogelijk om documenten via URL’s, hyperlinks en een browser met elkaar te verbinden en toegankelijk te maken.
CERN beschrijft die ontstaansgeschiedenis uitgebreid in The birth of the Web.
1990–1991: de eerste website ter wereld
Eind 1990 had Berners-Lee bij CERN de belangrijkste onderdelen van zijn idee werkend.
Hij ontwikkelde een webserver en de eerste browser, toepasselijk WorldWideWeb genoemd. Die software draaide op een NeXT-computer.
Op diezelfde computer werd ook de eerste website gehost.
Het adres?
info.cern.ch
De website ging over het World Wide Web zelf en legde onder andere uit wat het project was, hoe je een webserver kon opzetten en hoe je webpagina’s kon maken.
In 1991 werd de technologie breder beschikbaar en begon het web zich buiten CERN te verspreiden.
Wie benieuwd is hoe die allereerste website eruitzag, kan via CERN nog steeds een reconstructie van de eerste website bekijken.
Vergeleken met een moderne website ziet ze er bijna absurd eenvoudig uit.
Maar één fundamenteel concept is onmiddellijk herkenbaar: tekst bevat links waarmee je naar andere informatie kunt navigeren.
Meer dan dertig jaar later vormt dat nog altijd de basis van het web.
1993: het web wordt voor iedereen beschikbaar
Een beslissend moment volgde op 30 april 1993.
CERN maakte de software achter het World Wide Web publiek beschikbaar. Later werd ook een open licentie gebruikt.
Daardoor konden anderen de technologie vrij gebruiken en verder ontwikkelen.
Het web begon vervolgens snel te groeien.
Browsers maakten het toegankelijker voor mensen zonder technische kennis. Vooral Mosaic, dat in 1993 verscheen, speelde daarin een belangrijke rol doordat tekst en afbeeldingen binnen dezelfde interface weergegeven konden worden.
Websites begonnen daardoor langzaam te evolueren van voornamelijk tekstuele documenten naar een visueler medium.
Midden jaren 90: webdesign ontstaat
Naarmate meer bedrijven en organisaties het web ontdekten, veranderde ook wat van een website verwacht werd.
Een pagina hoefde niet langer uitsluitend informatie beschikbaar te maken.
Ze moest er ook goed uitzien.
Alleen waren de mogelijkheden daarvoor bijzonder beperkt.
HTML was in de eerste plaats ontworpen om de structuur van een document te beschrijven, niet om complexe layouts te bouwen.
Webdesigners werden daarom creatief.
HTML-tabellen, oorspronkelijk bedoeld om gegevens in rijen en kolommen weer te geven, werden gebruikt om volledige websites vorm te geven. Transparante afbeeldingen van één pixel hielpen om witruimte te creëren. Tekst werd soms als afbeelding opgeslagen omdat ontwerpers nauwelijks controle hadden over lettertypes.
Vanuit hedendaags webdesign bekeken klinkt dat omslachtig.
Destijds waren het manieren om de visuele grenzen van HTML te omzeilen.
1996: CSS verandert hoe websites worden vormgegeven
Een enorme stap vooruit kwam met CSS: Cascading Style Sheets.
CSS maakte het mogelijk om de presentatie van een webpagina los te koppelen van de inhoud en structuur.
HTML kon beschrijven wat iets was — bijvoorbeeld een titel of paragraaf — terwijl CSS kon bepalen hoe het eruitzag.
Denk aan kleuren, lettertypes, marges en afstanden.
CSS1 werd op 17 december 1996 een officiële W3C Recommendation.
Dat klinkt vandaag vanzelfsprekend, maar het was een fundamentele verandering.
In plaats van op iedere afzonderlijke pagina dezelfde visuele instellingen te herhalen, kon één stylesheet gebruikt worden om de uitstraling van meerdere pagina’s te bepalen.
Daarmee werd het veel eenvoudiger om een website consequent vorm te geven en te onderhouden.
Eind jaren 90: Flash brengt beweging naar het web
Tegen het einde van de jaren negentig werden websites steeds ambitieuzer.
Macromedia Flash — oorspronkelijk FutureSplash en later eigendom van Adobe — gaf ontwerpers mogelijkheden die met HTML en CSS op dat moment moeilijk te realiseren waren.
Animaties, geluid, interactieve navigatie en zelfs volledige websites konden in Flash gebouwd worden.
Webdesign werd daardoor een stuk spectaculairder.
Sommige websites begonnen met uitgebreide geanimeerde intro’s. Navigatie kon bewegen en geluid maken. Experimentele interfaces waren populair.
Achteraf bekeken ging dat soms behoorlijk ver.
De vrijheid van Flash zorgde niet automatisch voor goede gebruiksvriendelijkheid. Bovendien waren Flash-sites problematisch voor toegankelijkheid, zoekmachines en later mobiele apparaten.
Toch speelde Flash een belangrijke rol in de geschiedenis van webdesign. Het liet zien dat een website veel meer kon zijn dan een statisch document.
JavaScript maakt websites interactief
Ondertussen ontstond nog een technologie die veel belangrijker zou worden voor het moderne web: JavaScript.
JavaScript verscheen in 1995 en maakte het mogelijk om gedrag en interactie aan webpagina’s toe te voegen.
HTML zorgde voor structuur.
CSS voor vormgeving.
JavaScript voor gedrag.
Die combinatie vormt ook vandaag nog de technische basis van een enorm deel van het web.
De mogelijkheden van JavaScript zijn ondertussen nauwelijks vergelijkbaar met die van de eerste versies. Van eenvoudige interacties groeide de taal uit tot een technologie waarmee complexe webapplicaties gebouwd kunnen worden.
De jaren 2000: websites worden dynamisch
In de beginjaren bestond een website vaak uit afzonderlijke HTML-bestanden.
Wilde je op honderd pagina’s dezelfde navigatie aanpassen? Dan kon dat behoorlijk arbeidsintensief zijn.
Server-side programmeertalen, databases en contentmanagementsystemen veranderden dat.
Content kon voortaan dynamisch uit een database worden gehaald en in templates worden weergegeven.
Dat maakte websites veel gemakkelijker schaalbaar.
Blogs, nieuwssites, forums en webshops konden grote hoeveelheden content beheren zonder iedere pagina afzonderlijk in HTML te bouwen.
De opkomst van contentmanagementsystemen
Contentmanagementsystemen maakten publiceren bovendien toegankelijk voor mensen die zelf geen HTML konden schrijven.
WordPress verscheen bijvoorbeeld in 2003 en begon oorspronkelijk als bloggingplatform. Het groeide later uit tot een veel uitgebreider CMS waarmee allerlei soorten websites gebouwd kunnen worden.
Het principe was belangrijk: content beheren en een website technisch bouwen werden steeds meer van elkaar gescheiden.
Een redacteur kon een artikel schrijven zonder zelf de onderliggende pagina te programmeren.
Dat principe gebruiken we vandaag nog altijd.
Web 2.0: bezoekers worden deelnemers
Rond het midden van de jaren 2000 werd de term Web 2.0 populair.
Het ging niet om een officiële nieuwe versie van het World Wide Web, maar om een verandering in hoe websites gebruikt werden.
Het vroege web was grotendeels eenrichtingsverkeer: iemand publiceerde informatie en anderen lazen die.
Web 2.0 werd veel interactiever.
Gebruikers konden zelf content publiceren, reageren, profielen maken, foto’s uploaden en informatie delen. Blogs, Wikipedia, YouTube en sociale netwerken groeiden uit tot belangrijke onderdelen van het internetlandschap.
De website veranderde daardoor van een digitaal document in een platform voor interactie.
2007: de smartphone verandert webdesign opnieuw
De komst van moderne smartphones vormde een volgende grote uitdaging.
Websites waren jarenlang voornamelijk ontworpen voor desktopschermen met relatief voorspelbare afmetingen.
Plots moesten dezelfde pagina’s ook functioneren op een klein aanraakscherm.
Aanvankelijk werden daarvoor regelmatig afzonderlijke mobiele websites gebouwd.
Dat was niet ideaal.
Je moest meerdere versies onderhouden en gebruikers kregen afhankelijk van hun apparaat verschillende pagina’s.
Responsive webdesign bood uiteindelijk een veel elegantere oplossing.
Eén website kon zich met flexibele layouts, afbeeldingen en CSS media queries aanpassen aan verschillende schermformaten.
Vandaag beschouwen we dat als vanzelfsprekend.
Een website die uitsluitend op een desktop goed werkt is nauwelijks nog denkbaar. In ons artikel over mobiele optimalisatie bekijken we uitgebreider waarom een website niet alleen responsive, maar ook daadwerkelijk prettig bruikbaar moet zijn op kleinere schermen.
2014: HTML5 wordt een belangrijke mijlpaal
Ook HTML bleef evolueren.
Op 28 oktober 2014 publiceerde het W3C HTML5 als Recommendation.
HTML5 bracht en formaliseerde mogelijkheden die belangrijk werden voor moderne websites en webapplicaties.
Audio en video konden bijvoorbeeld rechtstreeks in de browser worden afgespeeld zonder daarvoor een plugin zoals Flash nodig te hebben. Er kwamen nieuwe semantische elementen en uitgebreidere mogelijkheden voor interactieve applicaties.
Dat hielp het open web steeds meer mogelijkheden te geven waarvoor vroeger externe technologie nodig was.
Flash verloor ondertussen terrein.
Browsers, HTML, CSS en JavaScript konden steeds meer zelf.
Adobe beëindigde uiteindelijk eind 2020 officieel de ondersteuning voor Flash Player.
Websites worden applicaties
Het onderscheid tussen een website en een programma werd vervolgens steeds kleiner.
Denk aan Gmail, Google Docs, Figma, Slack of webversies van uitgebreide bedrijfssoftware.
Ze draaien in een browser, maar gedragen zich veel meer als traditionele applicaties dan als de webpagina’s uit de jaren negentig.
JavaScript-frameworks, API’s, cloudinfrastructuur en steeds krachtigere browsers hebben daar een belangrijke rol in gespeeld.
Tegelijk werden websites verbonden met steeds meer andere systemen.
Een moderne bedrijfswebsite kan bijvoorbeeld communiceren met een CRM, boekhoudpakket, nieuwsbriefsoftware, reservatiesysteem, betaalprovider of externe database.
De website is daardoor steeds vaker één onderdeel van een groter digitaal ecosysteem.
Webdesign wordt steeds minder beperkt door techniek
Ook visueel is enorm veel veranderd.
CSS Grid en Flexbox maakten layouts mogelijk waarvoor vroeger ingewikkelde workarounds nodig waren. Webfonts gaven ontwerpers veel meer typografische vrijheid. SVG maakte schaalbare illustraties en iconen praktisch. Moderne browsers ondersteunen animaties, filters, gradients en allerlei grafische effecten.
Daardoor ligt de technische grens veel verder dan vroeger.
Maar dat betekent niet dat meer mogelijkheden automatisch betere websites opleveren.
De geschiedenis herhaalt zich op dat vlak enigszins.
Net zoals Flash ooit uitnodigde om zoveel mogelijk beweging en effecten te gebruiken, kunnen moderne webtechnieken verleiden tot animaties en interacties die weinig toevoegen.
Goed webdesign draait daarom niet om alles gebruiken wat technisch mogelijk is.
Het draait om de juiste techniek inzetten wanneer die de inhoud en gebruikerservaring ondersteunt.
Snelheid en gebruikservaring worden belangrijker
De verwachtingen van bezoekers zijn ondertussen eveneens veranderd.
Een website moet snel reageren, duidelijk navigeren en zonder frustratie functioneren op verschillende apparaten.
Google introduceerde Core Web Vitals om verschillende aspecten van de daadwerkelijke gebruikerservaring meetbaar te maken, waaronder laadsnelheid, responsiviteit en visuele stabiliteit.
Met Google Lighthouse kun je verschillende technische kwaliteitsaspecten van een website onderzoeken.
Maar een goede gebruikerservaring is breder dan een technische score.
Een pagina kan razendsnel laden en toch onduidelijk zijn.
Omgekeerd kan een visueel indrukwekkende website bezoekers verliezen wanneer navigatie verwarrend is, tekst moeilijk leesbaar is of belangrijke informatie verstopt zit.
In waarom bezoekers je website verlaten bekijken we verschillende van die drempels uitgebreider.
En nu verandert AI opnieuw hoe we het web gebruiken
De volgende verandering is al bezig.
Generatieve AI maakt het mogelijk om websites sneller te ontwerpen, code te genereren, teksten te schrijven en afbeeldingen te maken.
Tegelijk verandert AI ook hoe mensen informatie vinden.
Een gebruiker hoeft niet noodzakelijk meer verschillende websites te openen om een eenvoudige vraag te beantwoorden. Zoekmachines tonen generatieve antwoorden en systemen zoals ChatGPT kunnen informatie uit verschillende bronnen combineren.
Dat betekent niet dat websites verdwijnen.
Een website blijft een plaats waar een organisatie controle heeft over haar eigen informatie, merk, diensten, producten, cases en contactmogelijkheden.
Wel verandert mogelijk de weg waarlangs bezoekers die website ontdekken.
Dat raakt rechtstreeks aan SEO. In wat ChatGPT betekent voor SEO en online vindbaarheid bekijken we die ontwikkeling uitgebreider.
Van één HTML-pagina naar een volledig digitaal platform
Wanneer je de eerste website van CERN naast een moderne website zet, lijkt het bijna alsof ze niets met elkaar gemeen hebben.
Toch is de basis verrassend herkenbaar.
Documenten hebben een adres. Informatie wordt gestructureerd. Links verbinden pagina’s met elkaar. Een browser haalt informatie op van een server en toont die aan een gebruiker.
Wat veranderd is, is alles wat we daar bovenop gebouwd hebben.
CSS bracht visuele vormgeving. JavaScript interactie. Databases en CMS-systemen maakten websites dynamisch. Smartphones dwongen layouts zich aan verschillende schermen aan te passen. Moderne browsertechnologie veranderde websites in volwaardige applicaties.
En die evolutie stopt niet.
AI, nieuwe interfaces en toekomstige apparaten zullen opnieuw veranderen hoe we websites ontwerpen en gebruiken.
Maar één principe uit die allereerste website uit 1991 blijft bijzonder actueel:
het web bestaat om informatie toegankelijk te maken en met elkaar te verbinden.
Alle technologie die daarna kwam, bouwt uiteindelijk verder op dat eenvoudige idee.
Laatst aangepast: 24 september 2026.
Gerelateerde artikelen

SEO vs. SEA: wat is het verschil en wanneer kies je wat?
Wanneer je beter gevonden wilt worden in Google, kom je al snel twee termen tegen: SEO en SEA.
Beide hebben als doel om je onderneming zichtbaar te maken wanneer potentiële klanten zoeken naar je producten, diensten of informatie. De manier waarop ze dat doen is echter fundamenteel verschillend.
Met SEO probeer je je zichtbaarheid in de organische zoekresultaten te verbeteren. Met SEA betaal je om advertenties te tonen bij relevante zoekopdrachten.
Maar wat is nu precies het verschil tussen SEO en SEA? Wat kost het? Hoe snel zie je resultaat? En misschien nog belangrijker: moet je eigenlijk wel kiezen tussen beide?
Wat is SEO?
SEO staat voor Search Engine Optimization, of zoekmachineoptimalisatie.
Het omvat alle inspanningen waarmee je probeert een website beter vindbaar te maken in de organische resultaten van zoekmachines zoals Google.
Wanneer iemand bijvoorbeeld zoekt naar webdesign Herselt, bepaalt Google welke pagina’s volgens zijn systemen het meest relevant en bruikbaar zijn voor die zoekopdracht.
Je kunt Google niet betalen om een organische pagina hoger te plaatsen.
Dat betekent echter niet dat SEO gratis is.
Goede SEO vraagt tijd en expertise. Je moet onder andere nadenken over zoekintentie, content, websitestructuur, interne links, techniek, gebruikservaring en autoriteit.
Google geeft zelf een uitgebreid overzicht van de basis in zijn SEO Starter Guide.
Het voordeel is dat je daarmee iets opbouwt.
Een sterk kennisartikel of een goed geoptimaliseerde dienstenpagina kan maanden of zelfs jaren organisch bezoekers blijven aantrekken zonder dat je voor iedere klik aan Google betaalt.
Wil je de basis uitgebreider bekijken? In Hoger scoren in Google: 12 SEO-principes bespreken we de belangrijkste onderdelen van een duurzame SEO-strategie.
Wat is SEA?
SEA staat voor Search Engine Advertising: adverteren binnen zoekmachines.
Bij Google gebeurt dat via Google Ads.
Je maakt campagnes waarmee advertenties kunnen verschijnen wanneer iemand een relevante zoekopdracht uitvoert. Afhankelijk van je campagne bepaal je onder andere welke zoekopdrachten, locaties en doelgroepen relevant zijn en welk budget je wilt besteden.
Google bepaalt vervolgens via een advertentieveiling welke advertenties in aanmerking komen en waar ze verschijnen.
Daarbij draait het niet uitsluitend om wie het meeste betaalt. Google gebruikt Ad Rank, waarbij onder andere biedingen, relevantie en verschillende andere signalen een rol spelen.
Google legt zelf uit hoe dit proces werkt in de uitleg over Google Ads en de advertentieveiling.
Bij Search-campagnes betaal je doorgaans wanneer iemand daadwerkelijk op je advertentie klikt. Dat noemen we CPC: cost per click.
Stop je met adverteren, dan verdwijnt ook die betaalde zichtbaarheid.
Waar zie je SEO en SEA in Google?
Bij een zoekopdracht kunnen advertenties en organische zoekresultaten op dezelfde resultatenpagina verschijnen.
Betaalde resultaten worden door Google als advertenties aangeduid. De organische resultaten staan daar los van.
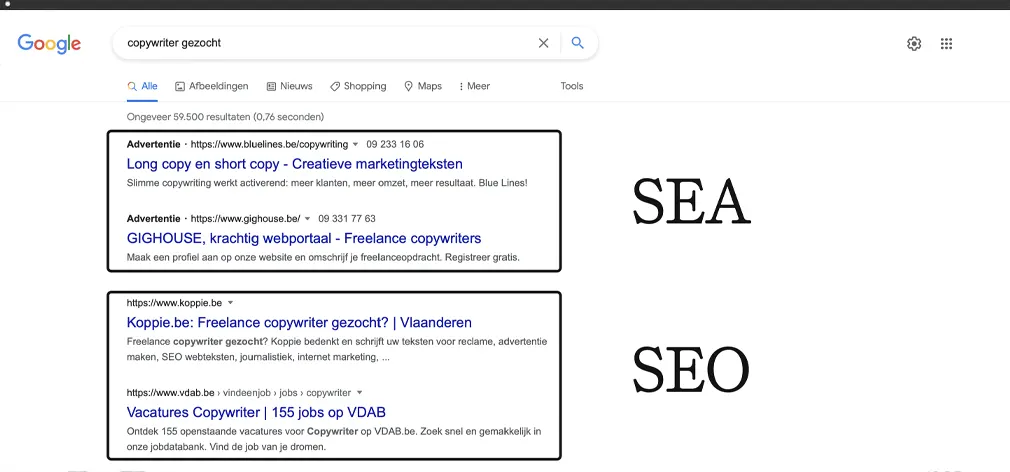
Google benadrukt zelf dat zijn organische zoekresultaten onafhankelijk zijn van zijn advertentieprogramma’s. Geld uitgeven aan Google Ads zorgt er dus niet voor dat je organische website daardoor hoger gaat scoren.
De precieze zoekresultatenpagina ziet er bovendien niet bij iedere zoekopdracht hetzelfde uit.
Naast traditionele links en advertenties kan Google bijvoorbeeld afbeeldingen, video’s, lokale resultaten, shoppingresultaten, featured snippets en AI-functionaliteit tonen.
SEO gaat daardoor vandaag om meer dan alleen proberen de eerste blauwe link te worden.
Wat is het belangrijkste verschil tussen SEO en SEA?
Het fundamentele verschil zit in hoe je zichtbaarheid verkrijgt.
Bij SEA koop je advertentieruimte. Zolang je campagnes actief zijn en voldoende budget hebben, kunnen je advertenties worden weergegeven bij relevante zoekopdrachten.
Bij SEO bouw je organische zichtbaarheid op door je website en content zo sterk mogelijk te maken voor relevante zoekopdrachten.
Dat verschil heeft gevolgen voor snelheid, kosten, controle en duurzaamheid.
| SEO | SEA | |
|---|---|---|
| Zichtbaarheid | Organische zoekresultaten | Betaalde advertenties |
| Betalen per klik | Nee | Doorgaans wel bij Search Ads |
| Snel resultaat mogelijk | Meestal niet | Ja |
| Resultaat na stoppen | Kan blijven bestaan | Betaalde zichtbaarheid stopt |
| Controle | Beperkter | Veel controle over campagnes |
| Langetermijnwaarde | Kan sterk opbouwen | Afhankelijk van blijvende investering |
Die verschillen betekenen niet dat de ene methode beter is dan de andere.
Ze maken SEO en SEA juist interessant voor verschillende doelen en momenten.
SEA kan veel sneller zichtbaarheid opleveren
Een van de grootste voordelen van SEA is snelheid.
Een nieuwe website heeft meestal niet onmiddellijk sterke organische posities. Met Google Ads kun je veel sneller zichtbaar worden voor relevante zoekopdrachten.
Dat kan interessant zijn bij bijvoorbeeld een nieuwe dienst, tijdelijke actie, evenement of campagne.
Je hebt bovendien veel controle.
Je kunt budgetten bepalen, geografisch targeten, campagnes tijdelijk stoppen en analyseren welke zoekopdrachten tot klikken en conversies leiden.
Google gebruikt tegenwoordig veel automatisering en machine learning binnen Search Ads. Ook keyword matching kijkt niet uitsluitend meer naar de letterlijke woorden die iemand intypt, maar kan onder andere betekenis en andere signalen gebruiken om relevante zoekopdrachten te koppelen.
Daarom vraagt SEA meer dan simpelweg enkele zoekwoorden invoeren en een dagbudget instellen.
Een goed ingerichte campagne moet opgevolgd en geoptimaliseerd worden.
SEO heeft tijd nodig, maar bouwt iets op
Bij SEO werkt het anders.
Een nieuwe pagina publiceren betekent niet dat je de volgende ochtend bovenaan Google staat.
Google moet de pagina kunnen ontdekken en verwerken en vervolgens bepalen hoe relevant die pagina is ten opzichte van andere beschikbare resultaten. Concurrentie speelt daarbij uiteraard ook een belangrijke rol.
SEO is daarom meestal een strategie voor de langere termijn.
Het interessante is dat je investeert in je eigen website en content.
Een goed artikel blijft bestaan wanneer je er morgen geen advertentiebudget meer tegenaan zet. Een verbeterde websitestructuur helpt ook andere pagina’s. Sterke interne links kunnen verschillende delen van de website ondersteunen.
Dat betekent niet dat rankings permanent zijn.
Concurrenten verbeteren hun websites, zoekgedrag verandert en Google past zijn systemen voortdurend aan. SEO vraagt dus eveneens opvolging.
Maar het opgebouwde werk verdwijnt niet onmiddellijk wanneer je even stopt met investeren.
Is SEO dan goedkoper dan SEA?
Niet noodzakelijk.
De uitspraak SEO is gratis en SEA kost geld is misleidend.
Voor een organische klik betaal je inderdaad geen bedrag aan Google. Maar iemand moet wel onderzoek doen, content schrijven, technische problemen oplossen, pagina’s verbeteren en resultaten opvolgen.
Dat kan je zelf doen of uitbesteden.
SEO heeft dus ook een kost.
Bij SEA is die kost alleen veel directer zichtbaar. Je hebt advertentiebudget en mogelijk kosten voor het beheren en optimaliseren van de campagnes.
Welke methode uiteindelijk goedkoper is per nieuwe klant hangt af van enorm veel factoren: concurrentie, marges, zoekvolume, conversieratio, kwaliteit van de website en de waarde van een klant.
Daarom zou ik SEO en SEA niet vergelijken op basis van “welke is goedkoper?”, maar eerder:
Welke investering helpt het best om mijn huidige doel te bereiken?
Wanneer is SEA interessant?
SEA wordt vooral interessant wanneer je relatief snel relevante bezoekers wilt bereiken en bereid bent daarvoor advertentiebudget te gebruiken.
Denk bijvoorbeeld aan:
- een nieuwe website die organisch nog weinig zichtbaarheid heeft;
- een tijdelijke campagne of promotie;
- een nieuwe dienst of productlancering;
- zoekopdrachten met een duidelijke commerciële intentie;
- het testen van verschillende aanbiedingen of landingspagina’s;
- markten waarin je heel gericht bepaalde regio’s of doelgroepen wilt bereiken.
Het grote voordeel is meetbaarheid.
Je kunt bijvoorbeeld zien welke campagnes, advertenties en zoekopdrachten klikken en conversies opleveren.
Maar daar hoort een belangrijke voorwaarde bij: de pagina waarop iemand terechtkomt moet goed zijn.
Advertentiebudget lost een slechte website niet op.
Wanneer bezoekers op je advertentie klikken maar vervolgens afhaken door een trage, onduidelijke of ongeloofwaardige landingspagina, betaal je uiteindelijk vooral om meer mensen naar een probleem te sturen.
Wanneer is SEO interessant?
SEO is vooral interessant wanneer er structureel gezocht wordt naar onderwerpen die relevant zijn voor je onderneming.
Dat kunnen commerciële zoekopdrachten zijn, maar ook vragen die potentiële klanten eerder in hun beslissingsproces stellen.
Een boekhouder kan bijvoorbeeld niet alleen gevonden worden op boekhouder Antwerpen, maar ook informatie publiceren over vragen die ondernemers regelmatig hebben.
Zo bouw je doorheen de tijd een bibliotheek van relevante pagina’s op.
SEO past daardoor goed bij bedrijven die duurzame organische zichtbaarheid willen opbouwen en bereid zijn daar consequent in te investeren.
Content alleen is daarbij niet voldoende.
Technische kwaliteit, mobiele bruikbaarheid, websitestructuur en interne links blijven eveneens belangrijk. Onze SEO-woordenlijst geeft een overzicht van veel begrippen die je daarbij tegenkomt.
SEO en SEA hoeven geen concurrenten te zijn
Dit is misschien wel het belangrijkste punt van het artikel.
Je hoeft niet noodzakelijk te kiezen.
SEO en SEA kunnen elkaar juist goed aanvullen.
Stel dat je een nieuwe dienstenpagina lanceert. Organisch kan het tijd kosten voordat die pagina zichtbaarheid opbouwt. Met SEA kun je ondertussen al gericht verkeer aantrekken.
De informatie uit advertentiecampagnes kan vervolgens inzichten geven in zoekgedrag en conversie. SEO-data kan omgekeerd interessante onderwerpen en zoekopdrachten blootleggen die ook voor advertenties relevant zijn.
Je kunt bovendien advertenties gebruiken voor strategisch belangrijke zoekopdrachten waarop je organisch nog niet sterk zichtbaar bent.
Het doel is uiteindelijk niet om zoveel mogelijk SEO of zoveel mogelijk SEA te doen.
Het doel is om op de juiste momenten zichtbaar te zijn voor de juiste mensen.
Vergeet de website achter SEO en SEA niet
Zowel SEO als SEA kunnen bezoekers naar je website brengen.
Daar stopt het werk niet.
Iemand moet vervolgens begrijpen wat je aanbiedt, vertrouwen krijgen en gemakkelijk een volgende stap kunnen zetten.
Daarom spelen webdesign, content en conversie bij beide kanalen een belangrijke rol.
Een goede advertentie met een slechte landingspagina kan geld verspillen. Een nummer-éénpositie in Google heeft weinig waarde wanneer bezoekers onmiddellijk terug vertrekken omdat ze niet vinden wat ze zoeken.
In waarom bezoekers je website verlaten bekijken we verschillende oorzaken waardoor een website verkeer wel aantrekt, maar bezoekers vervolgens opnieuw verliest.
En wanneer je wijzigingen aan belangrijke landingspagina’s wilt vergelijken, kan A/B-testing helpen om beslissingen met data te onderbouwen.
Wat kies je: SEO of SEA?
Dat hangt af van je doel.
Wil je op korte termijn een specifieke campagne zichtbaar maken? Dan kan SEA interessant zijn.
Wil je structureel organische zichtbaarheid opbouwen rond onderwerpen die belangrijk zijn voor je onderneming? Dan is SEO een logische investering.
In veel gevallen is de interessantste strategie echter geen keuze tussen beide.
SEA kan snel verkeer en data opleveren, terwijl SEO op langere termijn een sterkere organische basis opbouwt.
Bekijk daarom eerst waar je vandaag staat.
Voor welke zoekopdrachten ben je al zichtbaar? Waar liggen kansen? Welke zoektermen leveren daadwerkelijk klanten op? Hoe sterk zijn je landingspagina’s? En hoeveel tijd en budget kun je investeren?
SEO en SEA zijn twee verschillende manieren om dezelfde persoon te bereiken op het moment dat die actief naar iets zoekt.
De juiste verhouding tussen beide hangt af van je onderneming, markt en doelstellingen.
Laatst aangepast: 25 september 2026.
Gerelateerde artikelen
Google Discover: wat is het en hoe kom je erin?
Google Discover kan bezoekers naar je website brengen zonder dat ze op dat moment actief naar jouw onderwerp zoeken.
Dat maakt het fundamenteel anders dan de klassieke zoekresultaten van Google.
In plaats van te reageren op een ingevoerde zoekopdracht, probeert Discover content te tonen die aansluit bij de interesses van een gebruiker. Artikels, video’s en andere content kunnen daardoor plots een groot publiek bereiken.
Maar kun je eigenlijk optimaliseren voor Google Discover? Aan welke voorwaarden moet je website voldoen? En hoe vergroot je de kans dat jouw content wordt opgenomen?
Wat is Google Discover?
Google Discover is een gepersonaliseerde contentfeed van Google die gebruikers informatie toont op basis van hun interesses.
Je vindt Discover onder andere in de Google-app op mobiele apparaten en op bepaalde mobiele Google-ervaringen.
Het grote verschil met de gewone Google-zoekmachine is dat je geen zoekopdracht hoeft in te voeren.
Google probeert zelf te voorspellen welke onderwerpen je interessant vindt en toont vervolgens content die daarbij aansluit.
Volgens Google’s officiële documentatie over Discover wordt die personalisatie onder andere gebaseerd op interesses en Web & App Activity.
Dat maakt Discover eerder een aanbevelingssysteem dan een traditionele zoekmachine.
Google Search en Google Discover werken anders
Stel dat je wilt weten hoe je een logo kiest.
In Google Search voer je bijvoorbeeld waar moet een goed logo aan voldoen in. Google probeert vervolgens resultaten te tonen die bij die concrete zoekopdracht passen.
Bij Discover hoeft die zoekopdracht er niet te zijn.
Wanneer Google op basis van eerdere activiteit denkt dat je geïnteresseerd bent in branding en grafisch ontwerp, kan een relevant artikel daarover spontaan in je Discover-feed verschijnen.
Dat verschil heeft gevolgen voor SEO.
Bij traditionele SEO vertrek je vaak vanuit een zoekvraag of zoekintentie. Je onderzoekt waar mensen naar zoeken en maakt een pagina die daar zo goed mogelijk op aansluit.
Bij Discover speelt interesse een veel grotere rol.
Je kunt daardoor niet simpelweg een focus keyphrase kiezen en verwachten dat je daarmee in Discover verschijnt.
Wie kan in Google Discover verschijnen?
In principe heb je geen speciale registratie nodig.
Google geeft aan dat een pagina automatisch in aanmerking kan komen voor Discover wanneer ze door Google geïndexeerd is en voldoet aan de contentrichtlijnen van Discover.
Je hoeft daarvoor geen speciale structured data of Discover-tag toe te voegen.
In aanmerking komen betekent echter niet dat je ook daadwerkelijk getoond zult worden.
Google bepaalt automatisch welke content geschikt is voor een specifieke gebruiker.
Daarbij kan allerlei content verschijnen. Discover is dus niet uitsluitend bedoeld voor grote nieuwswebsites.
Ook oudere content kan opnieuw worden aanbevolen wanneer ze relevant en interessant is voor een gebruiker.
Dat maakt Discover interessant voor websites die sterke evergreen content combineren met actuele onderwerpen.
Hoe bepaalt Google welke content in Discover verschijnt?
Google maakt de exacte werking van zijn systemen uiteraard niet openbaar.
Wel geeft het behoorlijk duidelijke richtlijnen over het soort content dat het graag in Discover ziet.
Veel daarvan sluit aan bij algemene SEO-principes.
Content moet behulpzaam en betrouwbaar zijn, een goede gebruikerservaring bieden en in de eerste plaats voor mensen gemaakt zijn.
Voor Discover legt Google daarnaast nadruk op content die actueel is voor bestaande interesses, een verhaal goed vertelt of unieke inzichten biedt.
Sinds de Discover Core Update van 2026 legt Google bovendien explicieter de nadruk op originele en diepgaande content van websites die expertise rond een bepaald onderwerp laten zien.
Dat betekent niet dat je website maar over één onderwerp mag gaan.
Google probeert expertise per onderwerp te begrijpen. Een website kan dus op verschillende domeinen kennis aantonen, zolang daar voldoende inhoudelijke diepgang achter zit.
1. Maak content voor je doelgroep, niet voor Discover
Dit klinkt misschien tegenstrijdig, maar de beste manier om voor Discover te optimaliseren is niet voortdurend proberen te bedenken wat het algoritme wil zien.
Begin bij je doelgroep.
Welke onderwerpen interesseren hen? Welke ontwikkelingen zijn relevant? Welke vragen leven er? Waar heb jij ervaring of expertise die iets toevoegt aan wat al online staat?
Google noemt dit people-first content: informatie die in de eerste plaats gemaakt is om mensen te helpen, niet om zoekmachines te manipuleren.
Dat principe geldt zowel voor gewone Google Search als voor Discover.
Een website die plots tientallen artikels over populaire onderwerpen publiceert die niets met haar normale expertise te maken hebben, bouwt daardoor niet automatisch een sterke Discover-strategie.
Werk liever verder rond onderwerpen waarvoor je daadwerkelijk iets te vertellen hebt.
In Hoger scoren in Google: 12 SEO-principes bekijken we uitgebreider waarom sterke, originele content ook binnen traditionele SEO de basis blijft.
2. Zorg voor originele inhoud en eigen expertise
Dit punt is in 2026 nog belangrijker geworden.
Google geeft bij zijn recente Discover-update aan meer originele, diepgaande en actuele content te willen tonen van websites die expertise rond het betreffende onderwerp hebben.
Een samenvatting maken van wat tien andere websites al geschreven hebben, geeft weinig reden om juist jouw artikel aan iemand aan te bevelen.
Eigenheid kan op verschillende manieren ontstaan.
Je kunt eigen ervaring delen, praktijkvoorbeelden gebruiken, een onderwerp vanuit een specifieke invalshoek bekijken, eigen foto’s tonen, onderzoek uitvoeren of kennis uit echte projecten verwerken.
Voor The Other Concept zou dat bijvoorbeeld kunnen betekenen dat we niet alleen schrijven over wat een goede website theoretisch nodig heeft, maar concrete observaties delen vanuit websites die we bouwen en beheren.
Dat maakt content moeilijker uitwisselbaar.
En juist in een wereld waarin met AI op grote schaal generieke content geproduceerd kan worden, wordt dat verschil steeds belangrijker.
3. Besteed extra aandacht aan je afbeeldingen
Discover is sterk visueel.
Een goede afbeelding is daardoor niet alleen decoratie bij je artikel, maar een belangrijk onderdeel van hoe de content gepresenteerd kan worden.
Google adviseert voor Discover grote, relevante afbeeldingen van hoge kwaliteit.
Concreet beveelt Google afbeeldingen aan die minstens 1200 pixels breed zijn en meer dan 300.000 pixels bevatten. Een verhouding van ongeveer 16:9 is geschikt omdat Google afbeeldingen in Discover vaak liggend presenteert.
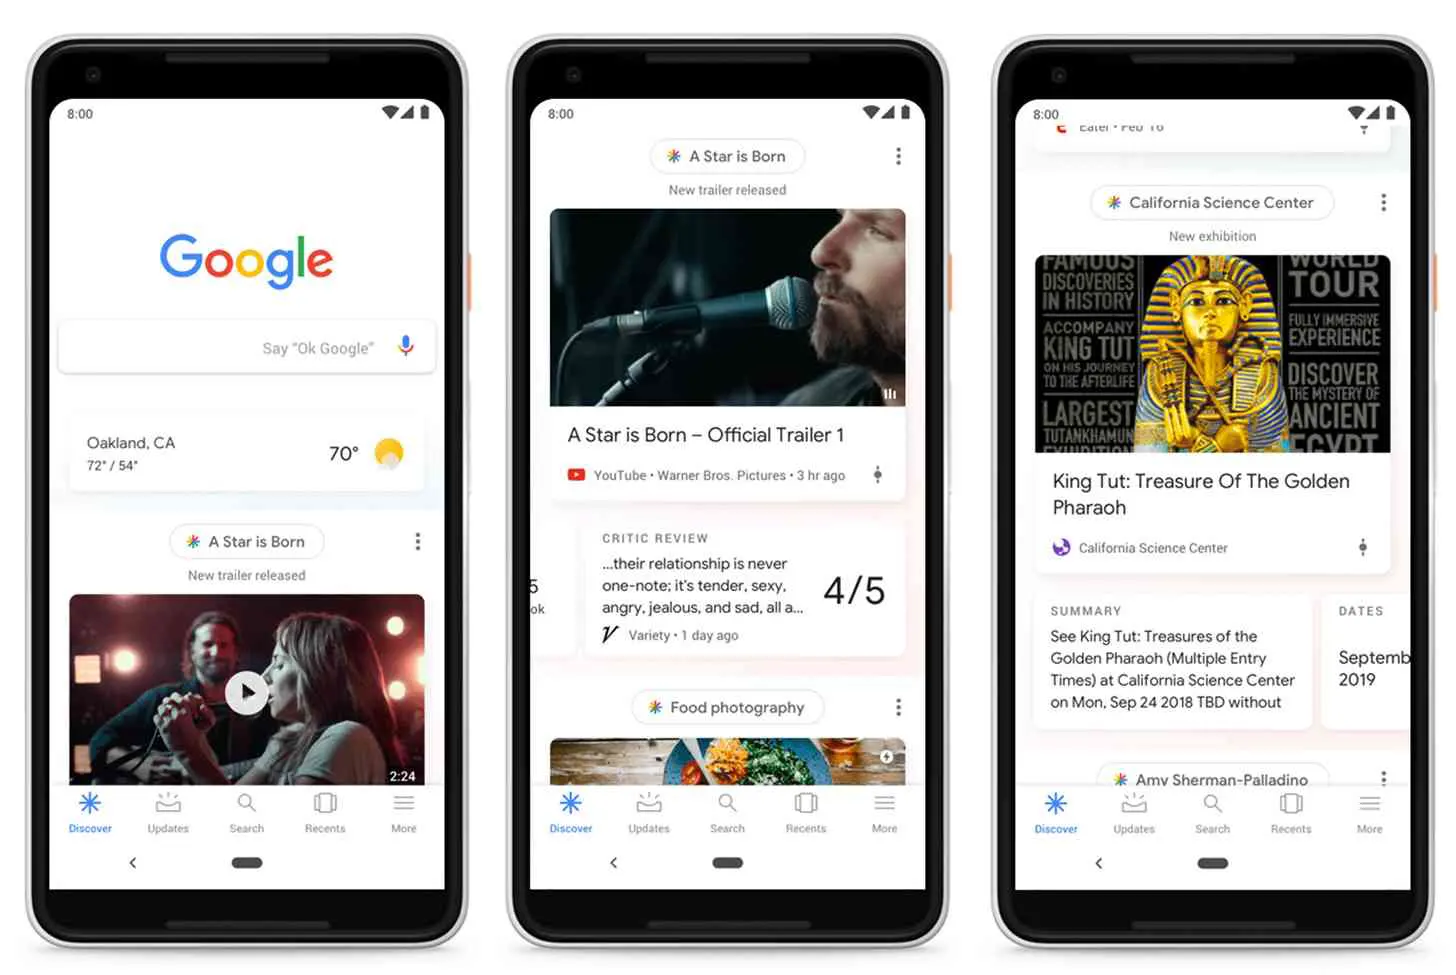
Gebruik bovendien een afbeelding die daadwerkelijk bij het artikel past.
Een generieke stockfoto of simpelweg je bedrijfslogo is meestal minder interessant dan een sterke afbeelding die onmiddellijk iets over het onderwerp vertelt.
Vermijd ook afbeeldingen die grotendeels uit tekst bestaan.
Google kan zowel structured data als de og:image-metadata gebruiken om te bepalen welke afbeelding als thumbnail bij een pagina wordt weergegeven.
Controleer max-image-preview:large
Wil je Google toestaan om je afbeeldingen groot weer te geven, dan is ook de instelling `max-image-preview:large` relevant.
Die kan bijvoorbeeld via een robots-metatag worden ingesteld:
<meta name="robots" content="max-image-preview:large">
Hiermee geef je Google toestemming om een grotere afbeeldingpreview te gebruiken.
Google adviseert deze instelling expliciet voor Discover.
Gebruik je WordPress en Yoast SEO, dan hoef je dit normaal niet handmatig op iedere pagina toe te voegen. Controleer wel even de broncode van een artikel wanneer je wilt weten welke robots-instructies daadwerkelijk worden gegenereerd.
4. Schrijf sterke titels zonder clickbait
In een gepersonaliseerde feed moet een titel voldoende duidelijk en interessant zijn om aandacht te trekken.
Dat betekent niet dat je hem sensationeel moet maken.
Integendeel.
Google adviseert expliciet om misleidende, overdreven of sensationele titels te vermijden.
Een titel zoals:
Deze 7 SEO-geheimen wil Google absoluut niet dat je kent!
kan nieuwsgierigheid creëren, maar vertelt nauwelijks wat iemand werkelijk gaat lezen.
Een titel als:
7 technische SEO-problemen die we vaak tegenkomen bij WordPress-websites
is veel concreter.
De beste titel probeert dus niet zoveel mogelijk klikken uit te lokken. Hij maakt duidelijk waarom de inhoud interessant is voor de juiste lezer.
Dat principe geldt trouwens ook buiten Discover.
5. Combineer evergreen content met actuele onderwerpen
Discover wordt vaak geassocieerd met nieuws en actualiteit, maar Google zegt expliciet dat ook oudere content kan verschijnen wanneer die relevant blijft voor iemands interesses.
Je hoeft dus niet dagelijks nieuwsartikels te publiceren.
Een sterke contentstrategie kan juist bestaan uit een combinatie.
Evergreen artikels beantwoorden vragen die langere tijd relevant blijven. Actuelere artikels spelen in op ontwikkelingen binnen je vakgebied.
Voor The Other Concept is dit artikel zelf bijvoorbeeld grotendeels evergreen, terwijl een artikel over een specifieke Google-update veel tijdsgevoeliger is.
Beide kunnen waarde hebben.
Het belangrijkste is dat je geen actualiteit probeert te creëren waar die niet bestaat. Verander bijvoorbeeld niet ieder jaar simpelweg SEO-tips voor 2025 naar SEO-tips voor 2026 wanneer de inhoud verder niet gewijzigd is.
Een publicatie- of wijzigingsdatum moet een echte verandering weerspiegelen.
6. Zorg voor een goede mobiele gebruikerservaring
Discover wordt sterk geassocieerd met mobiele consumptie.
Een artikel dat in een aantrekkelijke Discover-card verschijnt maar vervolgens naar een frustrerende mobiele pagina leidt, biedt geen goede ervaring.
Zorg daarom dat teksten prettig leesbaar zijn, afbeeldingen correct schalen, navigatie bruikbaar blijft en storende overlays de content niet onmiddellijk bedekken.
Ook snelheid en visuele stabiliteit spelen mee in de totale page experience.
Google benadrukt daarbij dat je niet één afzonderlijke technische metriek moet optimaliseren en vervolgens aannemen dat je gebruikerservaring perfect is.
Het gaat om het geheel.
In Mobiele optimalisatie: waarom je website niet zonder kan bekijken we uitgebreider waar een goede mobiele website aan moet voldoen.
7. Zorg dat Google je content technisch kan verwerken
Er bestaat geen speciale technische truc om een pagina aan Discover toe te voegen.
De basis moet gewoon goed zitten.
Je pagina moet geïndexeerd kunnen worden door Google en voldoen aan de Discover-richtlijnen.
Dat betekent dat veel normale SEO-principes ook hier blijven gelden: een crawlbare website, duidelijke pagina’s, correcte indexering en technisch gezonde content.
Je hebt geen aparte Discover-sitemap nodig en ook geen speciale schema markup die je toegang tot Discover geeft.
Structured data kan uiteraard nog steeds nuttig zijn om Google informatie over je pagina te geven, maar het is geen toegangsticket voor Discover.
Met Google Lighthouse kun je verschillende technische aspecten van je pagina controleren, al vertelt een perfecte Lighthouse-score uiteraard niet of een artikel in Discover zal verschijnen.
8. Bouw inhoudelijke autoriteit rond je onderwerpen op
Eén uitstekend artikel kan veel bereiken, maar Google probeert ook te begrijpen waar een website als geheel expertise rond heeft.
Dat maakt een goede contentstructuur interessant.
Wanneer je regelmatig kwalitatieve content rond webdesign publiceert, ontstaat een veel duidelijker inhoudelijk profiel dan wanneer je vandaag over webdesign schrijft, morgen over cryptomunten en volgende week over gezonde recepten omdat die onderwerpen toevallig populair zijn.
Verbind gerelateerde content bovendien met interne links.
Een artikel over mobiele optimalisatie kan bijvoorbeeld verwijzen naar performance, gebruikservaring of responsive webdesign. Zo ontstaat een netwerk van inhoudelijk gerelateerde pagina’s.
Dat helpt bezoekers verder en maakt de relaties tussen onderwerpen duidelijker.
Kun je garanderen dat je in Google Discover verschijnt?
Nee.
En dat is een belangrijk verschil met sommige technische SEO-optimalisaties.
Je kunt ervoor zorgen dat je content in aanmerking komt voor Discover en je kunt de kans vergroten dat ze aantrekkelijk en relevant genoeg is om getoond te worden.
Maar je kunt geen pagina indienen met de opdracht:
Toon dit artikel in Discover.
Google bepaalt automatisch welke content bij de interesses van individuele gebruikers past.
Zelfs websites die regelmatig veel Discover-verkeer ontvangen kunnen grote schommelingen zien.
Google waarschuwt daar zelf voor.
Discover-verkeer is volgens Google minder voorspelbaar dan verkeer vanuit gewone zoekopdrachten en moet daarom eerder als aanvullend verkeer worden beschouwd dan als een stabiele vervanging voor organisch zoekverkeer.
Bouw je volledige contentstrategie dus niet rond Discover.
Zie het als een extra mogelijkheid om sterke content bij een relevant publiek te krijgen.
Hoe weet je of je verkeer uit Google Discover krijgt?
Daarvoor gebruik je Google Search Console.
Wanneer je website voldoende vertoningen in Discover heeft ontvangen, verschijnt binnen Search Console een afzonderlijk prestatierapport voor Discover.
Daar kun je onder andere zien hoeveel vertoningen en klikken je content heeft gekregen en wat de CTR was.
Google rapporteert daar Discover-data van de afgelopen 16 maanden, zolang je website aan de minimale drempel voor vertoningen voldoet.
Zie je geen Discover-rapport?
Dat betekent niet noodzakelijk dat er technisch iets mis is met je website. Het kan simpelweg betekenen dat er onvoldoende Discover-data beschikbaar is om het rapport te tonen.

Kijk bij analyse niet alleen naar totaal verkeer.
Onderzoek vooral welke artikels worden opgepikt. Misschien ontdek je patronen in onderwerpen, formats of afbeeldingen die bij jouw publiek goed werken.
Gebruik die informatie als inzicht, niet als formule die je vervolgens op ieder artikel kopieert.
Google Discover is geen afzonderlijke SEO-strategie
Het aantrekkelijke aan Discover is duidelijk.
Een artikel kan plots bij duizenden geïnteresseerde gebruikers verschijnen zonder dat zij daar eerst een specifieke zoekopdracht voor hebben ingevoerd.
Maar er bestaat geen magische Discover-optimalisatie.
De fundamenten zijn opvallend vertrouwd: schrijf goede content voor een duidelijk publiek, toon echte expertise, gebruik sterke afbeeldingen, bied een goede gebruikerservaring en zorg dat Google je website technisch kan verwerken.
De Discover Core Update van 2026 versterkt dat beeld alleen maar. Google wil meer originele en diepgaande content van bronnen die aantoonbaar kennis hebben van het onderwerp, en minder sensationele content die vooral probeert klikken uit te lokken.
Dat sluit sterk aan bij hoe SEO in bredere zin evolueert.
Ook met de opkomst van AI-zoekervaringen wordt het steeds moeilijker om onderscheid te maken met content die alleen samenvat wat elders al beschikbaar is. In Wat betekent ChatGPT voor SEO en online vindbaarheid? bekijken we hoe die verandering invloed heeft op online vindbaarheid.
Maak dus geen content voor Discover. Maak content die goed genoeg is om ontdekt te worden.
Laatst bijgewerkt op 27 september 2026..
