

llms.txt: nuttig voor AI-vindbaarheid of vooral hype?

Websites worden niet langer alleen bezocht door mensen en traditionele zoekmachines. Ook AI-assistenten en agents halen informatie van het web om vragen te beantwoorden, documentatie te raadplegen of taken uit te voeren.
Daaruit ontstond een interessante vraag: kunnen we informatie op een website gemakkelijker toegankelijk maken voor deze systemen?
llms.txt probeert daar een antwoord op te bieden.
Het is een relatief nieuwe voorgestelde standaard waarmee je op een vaste plaats informatie en belangrijke bronnen van je website kunt aanbieden in een formaat dat gemakkelijk door taalmodellen en AI-agents verwerkt kan worden.
Maar rond llms.txt zijn ondertussen ook stevige claims ontstaan. Het zou de robots.txt voor AI zijn, noodzakelijk worden voor AI-vindbaarheid of ervoor zorgen dat je vaker in AI-antwoorden verschijnt.
Zo eenvoudig ligt het niet.
Wat is llms.txt?
llms.txt is een voorstel voor een standaard waarmee websites informatie beschikbaar kunnen maken voor Large Language Models (LLM’s) en AI-agents.
Het oorspronkelijke voorstel werd in september 2024 gepubliceerd door Jeremy Howard. In augustus 2026 verscheen versie 2 van de officiële llms.txt-specificatie, waarin het voorstel verder werd aangepast op basis van twee jaar praktijkervaring.
Het basisidee is eenvoudig.
Je plaatst een bestand met de naam:
llms.txt
op een vaste locatie van je website, bijvoorbeeld:
https://theotherconcept.be/llms.txt
In dat bestand geef je een korte beschrijving van de website en verwijs je naar belangrijke informatie en pagina’s.
Anders dan bijvoorbeeld een XML-sitemap gebruikt llms.txt daarvoor geen XML, maar Markdown.
Dat is bewust gekozen. Markdown bevat weinig overbodige opmaak en kan daardoor relatief eenvoudig door zowel mensen als machines gelezen en verwerkt worden.
Waarom werd llms.txt bedacht?
Een gewone webpagina is in eerste instantie voor mensen gebouwd.
Naast de eigenlijke inhoud bevat de HTML vaak navigatie, een footer, formulieren, scripts, advertenties, interactieve onderdelen en allerlei technische elementen.
Een browser weet hoe hij daar een visuele website van moet maken.
Een AI-agent die alleen bepaalde informatie nodig heeft, heeft al die elementen niet noodzakelijk nodig. Hij is vooral geïnteresseerd in de inhoud en de context daarvan.
De makers van llms.txt stellen daarom voor om belangrijke informatie op een compactere en voorspelbare manier beschikbaar te maken.
Het bestand functioneert daarbij eerder als een inhoudelijke wegwijzer voor AI-agents dan als een volledige kopie van je website.

Hoe ziet een llms.txt-bestand eruit?
Een llms.txt-bestand is verrassend eenvoudig.
Een vereenvoudigd voorbeeld voor een fictief webbureau zou er bijvoorbeeld zo kunnen uitzien:
# Voorbeeld Webbureau

> Webdesignbureau gespecialiseerd in websites, branding en SEO.

Wij ontwerpen en ontwikkelen websites voor bedrijven en organisaties.

## Diensten

- [Webdesign](https://theotherconcept.be/webdesign/): Websites op maat
- [Grafisch ontwerp](https://theotherconcept.be/grafisch-ontwerp-branding/): Branding en visuele identiteit
- [SEO](https://theotherconcept.be/seo-ai-vindbaarheid/): SEO en AI-vindbaarheid

## Kennisbank

- [Schema.org](https://theotherconcept.be/seo/schema-org/): Uitleg over structured data
- [XML-sitemap](https://theotherconcept.be/seo/xml-sitemap/): Uitleg over XML-sitemaps

## Contact

- [Contact](https://theotherconcept.be/contact/): Contactgegevens en aanvraagformulier
De huidige llms.txt-specificatie schrijft een eenvoudige structuur voor.
Een H1 met de naam van de website of het project vormt het verplichte onderdeel. Daarna kunnen een korte samenvatting, aanvullende informatie en verschillende H2-secties met relevante links volgen.
Je hoeft dus niet je volledige website in één gigantisch tekstbestand te kopiëren.
Het bestand helpt een systeem vooral begrijpen wat de website is en waar belangrijke informatie te vinden is.
llms.txt is geen robots.txt voor AI
Een vergelijking die je vaak tegenkomt is:
llms.txt is de robots.txt voor AI.
Dat klinkt aantrekkelijk, maar technisch klopt het niet.
Een robots.txt-bestand bevat regels waarmee website-eigenaars crawlers kunnen aangeven welke delen van een website ze wel of niet mogen crawlen.
llms.txt heeft een compleet andere functie.
Het probeert geen toegang te blokkeren of crawlrechten vast te leggen. Het biedt juist informatie en verwijzingen aan in een formaat dat gemakkelijk door AI-systemen verwerkt kan worden.
Heel eenvoudig:
robots.txt → instructies over crawling.
XML-sitemap → overzicht van belangrijke URL’s voor zoekmachines.
llms.txt → voorgestelde inhoudelijke wegwijzer voor AI-agents en LLM’s.
De bestanden kunnen dus naast elkaar bestaan omdat ze verschillende problemen proberen op te lossen.
Helpt llms.txt om beter gevonden te worden in Google?
Nee.
En dit is een belangrijke nuance.
Google heeft in juni 2026 expliciet verduidelijkt dat Google Search llms.txt niet nodig heeft en het bestand geen positieve of negatieve invloed heeft op zichtbaarheid of rankings.
Dat geldt ook voor de generatieve AI-functies binnen Google Search.
In zijn richtlijnen voor optimalisatie voor generatieve AI in Google Search geeft Google expliciet aan dat je geen speciale AI-bestanden, Markdown-versies of andere nieuwe machineleesbare bestanden hoeft te maken om in Google Search en zijn generatieve functies te verschijnen.
Een llms.txt-bestand toevoegen met de verwachting dat je daardoor hoger in Google komt of vaker in Google AI-antwoorden verschijnt, heeft volgens Google dus geen basis.

Heeft llms.txt dan helemaal geen nut?
Dat zou dan weer te kort door de bocht zijn.
Google Search gebruikt het bestand niet, maar dat betekent niet dat geen enkel ander systeem er iets mee kan.
De llms.txt-specificatie is ondertussen geëvolueerd naar versie 2 en wordt door verschillende websites en documentatieplatformen geïmplementeerd.
Een concreet voorbeeld is Cloudflare.
Cloudflare publiceert llms.txt-bestanden voor zijn documentatie en biedt daarnaast Markdown-versies van documentatiepagina’s aan. AI-agents kunnen zo rechtstreeks een overzicht van beschikbare documentatie raadplegen zonder eerst de volledige website-interface te moeten interpreteren.
Dat laat meteen zien waar llms.txt vandaag vooral interessant kan zijn: uitgebreide documentatie en websites waarvan informatie actief door AI-agents gebruikt wordt.
llms.txt versus llms-full.txt
Naast llms.txt kom je soms ook llms-full.txt tegen.
Dat is niet hetzelfde.
Een llms.txt-bestand is vooral bedoeld als overzicht of index. Het bevat context en verwijzingen naar relevante informatie.
Een llms-full.txt-bestand kan daarentegen veel meer inhoud rechtstreeks bundelen.
Cloudflare gebruikt bijvoorbeeld beide:
llms.txt bevat een gestructureerde directory van documentatie.
llms-full.txt bevat de inhoud van documentatie in één groter tekstbestand voor toepassingen zoals offline indexering en verwerking door modellen met een groot contextvenster.
Voor een gewone bedrijfswebsite is zo’n gigantisch bestand lang niet altijd nodig.
Ook hier geldt: meer informatie aanbieden is niet automatisch beter.
Versie 2 maakt llms.txt beter vindbaar voor agents
Een interessante ontwikkeling kwam er in augustus 2026 met versie 2 van het voorstel.
Een probleem met de oorspronkelijke aanpak was namelijk vrij fundamenteel.
Hoe weet een AI-agent die op een willekeurige webpagina terechtkomt dat er ergens een llms.txt-bestand of Markdown-versie beschikbaar is?
Versie 2 introduceert daarvoor standaard linkrelaties.
Met rel="describedby" kan een pagina verwijzen naar het llms.txt-bestand dat erop van toepassing is.
Met:
rel="alternate" type="text/markdown"
kan een website aangeven dat er ook een Markdown-versie van een pagina beschikbaar is.
Dat kan bijvoorbeeld via HTML of HTTP-headers gebeuren.
Het idee is dat agents daardoor minder hoeven te gokken waar machinevriendelijke versies van informatie te vinden zijn.
Wat heeft llms.txt met AI-vindbaarheid te maken?
Hier wordt het onderwerp interessanter voor bedrijven.
Wanneer we spreken over AI-vindbaarheid, gaat het uiteindelijk over de vraag hoe gemakkelijk machines betrouwbare informatie over een organisatie, product, dienst of onderwerp kunnen vinden, begrijpen en gebruiken.
llms.txt past binnen die gedachte.
Je kunt expliciet beschrijven wat je website doet en verwijzen naar de pagina’s die daarvoor de belangrijkste informatie bevatten.
Maar daaruit volgt niet automatisch dat een taalmodel die informatie ook daadwerkelijk gebruikt.
Een AI-systeem moet het bestand kennen, kunnen ophalen én ervoor kiezen om de informatie te verwerken.
Er bestaat momenteel geen universele afspraak dat alle belangrijke AI-systemen bij iedere website automatisch naar /llms.txt kijken.
Daarom zou ik llms.txt vandaag zien als een aanvullende technische laag, niet als fundament van AI-vindbaarheid.
En hoe verschilt llms.txt van Schema.org?
Ook Schema.org wordt vaak genoemd wanneer het over machineleesbare websites gaat.
Toch lossen beide iets anders op.
Schema.org voegt gestructureerde betekenis toe aan informatie op een webpagina.
Je kunt bijvoorbeeld expliciet aangeven dat iets een organisatie, persoon, product, artikel of evenement is. Eigenschappen kunnen vervolgens beschrijven welke naam, auteur, prijs of datum daarbij hoort.
llms.txt is veel meer een gecureerde toegangspoort tot informatie.
Je zegt als het ware:
Dit is onze website, dit is wat we doen en hier vind je de belangrijkste bronnen.
Bij Schema.org beschrijf je dus vooral de betekenis en relaties van gegevens. Met llms.txt organiseer en presenteer je belangrijke bronnen voor systemen die de standaard ondersteunen.
Ze kunnen elkaar daarom aanvullen, maar zijn niet onderling uitwisselbaar.
Is llms.txt interessant voor een gewone bedrijfswebsite?
Dat hangt ervan af.
Voor een grote documentatiewebsite, softwareplatform of API-provider is de toepassing vrij duidelijk. AI-agents hebben daar vaak behoefte aan actuele, technische informatie en kunnen via llms.txt gemakkelijker relevante documentatie vinden.
Voor een lokale onderneming met vijf pagina’s is de toegevoegde waarde veel minder duidelijk.
Zo’n website is voor moderne crawlers doorgaans al relatief eenvoudig te verwerken.
Toch kan het interessant zijn om met llms.txt te experimenteren wanneer je website veel inhoud bevat of wanneer AI-vindbaarheid bewust onderdeel is van je digitale strategie.
De technische implementatie kan bovendien relatief eenvoudig zijn.
Alleen zou ik andere werkzaamheden er niet voor laten liggen.
Wat is belangrijker dan llms.txt?
Voordat je tijd investeert in nieuwe AI-specifieke technieken, moet de basis goed zitten.
Voor Google zelf is de boodschap daarover behoorlijk duidelijk: de principes die al gelden voor Search blijven ook relevant voor de AI-functies binnen Google Search.
Denk onder andere aan:
- inhoud die daadwerkelijk antwoord geeft op vragen van je doelgroep;
- pagina’s die technisch toegankelijk en crawlbaar zijn;
- een duidelijke websitestructuur en relevante interne links;
- correcte en consistente informatie over je organisatie;
- goede titels en duidelijke contentstructuur;
- technisch correcte structured data waar die relevant is;
- originele informatie, expertise en inhoud die iets toevoegt.
Een perfect llms.txt-bestand kan zwakke, onduidelijke of onbetrouwbare websitecontent niet repareren. Het kan informatie gemakkelijker toegankelijk maken voor systemen die de standaard ondersteunen, maar machineleesbaarheid is niet hetzelfde als betrouwbaarheid.
Dat onderscheid kan zelfs belangrijker worden naarmate steeds meer online content met generatieve AI wordt geproduceerd. Wanneer AI-gegenereerde informatie opnieuw als bron voor andere websites en AI-systemen dient, wordt het steeds relevanter om te weten waar informatie oorspronkelijk vandaan komt. In als AI het internet schrijft, waar haalt AI straks zijn kennis vandaan? gaan we dieper in op AI-gegenereerde content, model collapse en het risico dat herhaling uiteindelijk op consensus begint te lijken.
Dat geldt overigens voor veel nieuwe technieken rond AI-optimalisatie. Nieuwe standaarden kunnen interessant zijn, maar ze vervangen originele informatie, betrouwbare bronnen en echte expertise niet.
Moet je nu een llms.txt-bestand toevoegen?
Voor de meeste bedrijfswebsites zou ik het vandaag als optioneel beschouwen.
Heb je een grote kennisbank, technische documentatie of veel inhoud die door AI-agents gebruikt kan worden? Dan wordt het interessanter.
Heb je een kleine website en moet je kiezen tussen een llms.txt-bestand maken of belangrijke pagina’s inhoudelijk verbeteren? Dan zou ik eerst de pagina’s verbeteren.
Het bestand is relatief eenvoudig te implementeren, dus experimenteren kan weinig kwaad zolang de informatie correct onderhouden wordt.
Verwacht alleen geen meetbare SEO-boost puur omdat het bestand bestaat.
Wat zou je erin kunnen opnemen?
Voor een bedrijfswebsite kun je bijvoorbeeld denken aan:
- een korte, feitelijke omschrijving van de onderneming;
- de belangrijkste diensten of producten;
- belangrijke kennis- of documentatiepagina’s;
- informatie over de organisatie;
- contact- of supportdocumentatie;
- andere bronnen die voor een AI-agent daadwerkelijk nuttig kunnen zijn.
Probeer vooral niet om er een document vol marketingclaims van te maken.
Een compacte, feitelijke structuur is veel logischer voor het doel waarvoor het bestand bedacht werd.
Kan llms.txt robots.txt vervangen?
Nee.
Het is belangrijk dat beide niet met elkaar verward worden.
Een robots.txt-bestand heeft een gevestigde functie binnen crawling op het web. Je kunt er crawlers mee aangeven welke URL-paden ze wel of niet mogen benaderen volgens het Robots Exclusion Protocol.
llms.txt regelt dergelijke toegangsrechten niet.
Wil je bepaalde AI-crawlers blokkeren of beperken, dan is een llms.txt-bestand daarvoor dus niet het juiste mechanisme.
Dat onderscheid wordt extra belangrijk nu website-eigenaars steeds bewuster nadenken over welke bots hun content mogen crawlen en waarvoor die content vervolgens gebruikt kan worden.
llms.txt is interessant, maar geen wondermiddel
llms.txt is een interessant voorbeeld van hoe het web zich probeert aan te passen aan een wereld waarin niet alleen mensen en zoekmachines websites bezoeken, maar ook steeds meer AI-agents.
De aanpak is logisch: geef machines een compacte, gestructureerde ingang naar belangrijke informatie en maak relevante content indien mogelijk beschikbaar in een eenvoudig te verwerken formaat.
De standaard wordt ondertussen daadwerkelijk gebruikt en versie 2 lost enkele praktische problemen rond vindbaarheid op.
Maar daar moeten we geen grotere beloftes aan koppelen dan we kunnen onderbouwen.
Google Search gebruikt llms.txt niet en het bestand verbetert je rankings of zichtbaarheid binnen Google niet. Andere systemen kunnen er wél gebruik van maken en vooral voor documentatie en agentgerichte toepassingen zien we concrete implementaties.
Bij The Other Concept bekijken we llms.txt daarom als één mogelijk onderdeel van een bredere aanpak rond SEO en AI-vindbaarheid.
Eerst zorgen dat je informatie goed, duidelijk en technisch toegankelijk is. Daarna kunnen nieuwe standaarden zoals llms.txt een interessante extra laag vormen.
Laatst bijgewerkt op 14 oktober 2026.
Gerelateerde artikelen





Schema.org: wat is structured data en waarom is het belangrijk?
Een bezoeker begrijpt meestal onmiddellijk wat hij op een webpagina ziet. Een naam is een bedrijfsnaam, een bedrag is de prijs van een product en vijf sterren naast een testimonial stellen waarschijnlijk een beoordeling voor.
Voor zoekmachines ligt dat anders.
HTML vertelt vooral hoe een pagina is opgebouwd. Met Schema.org kun je extra informatie toevoegen die expliciet beschrijft wat bepaalde gegevens betekenen. Je vertelt een zoekmachine bijvoorbeeld dat iets een organisatie, persoon, artikel, product, evenement of adres is.
Die informatie noemen we structured data of gestructureerde gegevens.
Schema.org is daarmee een interessante aanvulling op technische SEO. Niet omdat enkele regels code je website plots hoger in Google plaatsen, maar omdat je machines helpt de inhoud en betekenis van je website beter te begrijpen.
Wat is Schema.org?
Schema.org is een gezamenlijke standaard voor gestructureerde gegevens op het web.
Het project werd oorspronkelijk opgericht door Google, Microsoft, Yahoo en Yandex en wordt vandaag verder ontwikkeld als een open communityproject.
Schema.org bevat een uitgebreide woordenschat waarmee je kunt beschrijven wat bepaalde informatie op een webpagina voorstelt.
Stel bijvoorbeeld dat ergens op een website staat:
The Other Concept
Voor een bezoeker kan uit de context duidelijk zijn dat dit de naam van een onderneming is. Met Schema.org kun je die betekenis expliciet maken door aan te geven dat The Other Concept een Organization of, wanneer toepasselijk, een specifieker bedrijfstype is.
Hetzelfde kun je doen met een artikel, auteur, product, vacature, evenement, recept of locatie.
Schema.org bevat daarvoor honderden verschillende types en nog veel meer eigenschappen waarmee die types verder beschreven kunnen worden.

Wat is structured data?
Schema.org en structured data worden vaak als synoniemen gebruikt, maar technisch gezien zijn ze niet helemaal hetzelfde.
Schema.org is de woordenschat.
Structured data is de manier waarop je informatie gestructureerd aan machines doorgeeft.
Je kunt het vergelijken met een taal en een zin die je met die taal schrijft.
Schema.org bepaalt bijvoorbeeld dat er een type Article bestaat en dat je daar eigenschappen zoals een titel, auteur en publicatiedatum aan kunt koppelen.
Vervolgens plaats je die informatie in een formaat dat machines kunnen lezen.
Schema.org kan onder andere gebruikt worden via Microdata, RDFa en JSON-LD. Voor veel moderne implementaties is JSON-LD bijzonder praktisch, omdat de structured data los van de zichtbare HTML kan worden opgenomen.
Hoe ziet Schema.org eruit?
Stel dat je een blogartikel publiceert met de titel Wat is Schema.org?. Met JSON-LD zou een sterk vereenvoudigd voorbeeld er ongeveer zo kunnen uitzien:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "Wat is Schema.org?",
  "author": {
    "@type": "Organization",
    "name": "The Other Concept"
  },
  "publisher": {
    "@type": "Organization",
    "name": "The Other Concept"
  }
}
</script>
Een gewone bezoeker hoeft deze code niet te zien.
Voor machines bevat ze daarentegen expliciete informatie. We vertellen onder andere dat deze pagina een blogpost bevat en dat The Other Concept eraan gekoppeld is als auteur en uitgever.
In werkelijkheid kan een implementatie uitgebreider zijn. Bij een artikel kun je bijvoorbeeld ook de publicatiedatum, wijzigingsdatum, afbeeldingen en URL van de auteur meegeven.
Google ondersteunt voor artikels onder andere de Schema.org-types Article, NewsArticle en BlogPosting.
Waarom gebruiken zoekmachines structured data?
Een zoekmachine probeert voortdurend te begrijpen wat een pagina betekent.
De woorden op de pagina, titels, interne links, afbeeldingen en algemene structuur leveren daarvoor allerlei signalen. Interne links helpen daarbij om relaties tussen pagina’s en onderwerpen zichtbaar te maken, terwijl structured data expliciete machineleesbare informatie aan de inhoud toevoegt.
Je laat daardoor een deel van de betekenis minder aan interpretatie over.
Dat betekent niet dat Google blindelings gelooft wat je in je Schema.org-code zet. De structured data moet overeenkomen met de daadwerkelijke inhoud van de pagina.
Het voordeel zit vooral in duidelijkheid.
Met de juiste structured data kan een zoekmachine bijvoorbeeld beter herkennen:
- welke organisatie bij een website hoort;
- wie een artikel geschreven heeft;
- dat een pagina over een specifiek product gaat;
- wat de prijs en beschikbaarheid van dat product zijn;
- dat bepaalde informatie een evenement of vacature beschrijft;
- hoe verschillende onderdelen van een website met elkaar samenhangen.
Die expliciete betekenis is precies waarom structured data interessant is binnen technische SEO.
Schema.org en rich results in Google
Structured data kan in bepaalde gevallen ook gebruikt worden om pagina’s in aanmerking te laten komen voor uitgebreidere zoekresultaten.
Google noemt die rich results.
Afhankelijk van het type content kan Google extra informatie uit structured data gebruiken om een zoekresultaat anders weer te geven. Denk bijvoorbeeld aan bepaalde productinformatie, recepten of evenementen.
Maar hier is een belangrijke nuance nodig:
Schema.org toevoegen betekent niet automatisch dat je een rich result krijgt.
Google bepaalt zelf welke zoekresultaten en functies worden weergegeven. Bovendien ondersteunt Google voor zoekfuncties slechts een selectie van de veel grotere Schema.org-woordenschat.
Je moet daarom onderscheid maken tussen twee dingen:
Schema.org gebruiken om informatie semantisch te beschrijven
en
structured data gebruiken die door Google voor een specifieke zoekfunctie wordt ondersteund.
Dat zijn niet noodzakelijk dezelfde zaken.
Wie structured data implementeert met een specifiek Google-resultaat als doel, controleert daarom het best de actuele Google Search Gallery met ondersteunde structured data.
Zorgt Schema.org voor hogere posities in Google?
Dit is waarschijnlijk de belangrijkste misvatting rond structured data.
Schema.org is geen knop waarmee je rechtstreeks een hogere positie in Google koopt.
Je kunt dus niet simpelweg zoveel mogelijk schema’s aan een website toevoegen en verwachten dat je daardoor boven concurrenten verschijnt.
Structured data helpt zoekmachines vooral om de informatie op een pagina explicieter te begrijpen en kan, wanneer Google het betreffende type ondersteunt, helpen om in aanmerking te komen voor bepaalde zoekfuncties.
Goede SEO blijft veel breder.
Technische kwaliteit, relevante content, interne structuur, autoriteit, gebruiksvriendelijkheid en de mate waarin een pagina aansluit bij de zoekintentie blijven allemaal belangrijk.
Zie Schema.org daarom als een extra informatielaag bovenop een website die inhoudelijk en technisch al goed in elkaar zit.
Welke Schema.org-types zijn interessant voor een bedrijfswebsite?
Welke structured data nuttig is, hangt volledig af van de website.
Een lokale onderneming heeft andere informatie dan een webshop of nieuwssite.
Toch zijn er enkele types die regelmatig relevant kunnen zijn.
Organization en LocalBusiness
Met Organization kun je informatie over een organisatie structureren.
Voor lokale bedrijven bestaan daarnaast LocalBusiness en verschillende specifiekere subtypes.
Daarbij kunnen eigenschappen worden gekoppeld zoals de naam, URL, logo, contactgegevens en andere informatie die daadwerkelijk bij de organisatie hoort.
Het doel is niet om ieder denkbaar veld in te vullen. Voeg vooral correcte informatie toe die relevant is voor de onderneming en overeenkomt met wat op de website wordt gecommuniceerd.
Article en BlogPosting
Voor artikels zoals deze kan Article of het specifiekere BlogPosting gebruikt worden.
Daarmee kun je bijvoorbeeld duidelijk maken wat de titel is, wanneer het artikel gepubliceerd en aangepast werd en wie de auteur is.
Google geeft aan dat Article structured data kan helpen om meer informatie over een artikel te begrijpen, zoals de auteur, titel, afbeeldingen en datums.
Dat maakt correcte publicatie- en wijzigingsdatums extra interessant. Zeker wanneer oudere content regelmatig wordt geactualiseerd.
Product
Voor webshops is Product een belangrijk Schema.org-type.
Je kunt daarmee productinformatie structureren en koppelen aan bijvoorbeeld een merk, SKU en aanbiedingen. Binnen een Offer kunnen vervolgens gegevens zoals prijs, valuta en beschikbaarheid worden opgenomen.
Google ondersteunt uitgebreide structured data voor producten en kan dergelijke informatie gebruiken voor verschillende productgerelateerde ervaringen in Search.
BreadcrumbList
Breadcrumbs maken duidelijk waar een pagina zich binnen de structuur van een website bevindt.
Met BreadcrumbList kan die hiërarchie ook als structured data beschreven worden.
Dat is een mooi voorbeeld van Schema.org dat aansluit bij iets wat bezoekers eveneens helpt: een logische websitestructuur.
Moet je FAQ-schema aan je FAQ toevoegen?
Hier is het belangrijk om niet met verouderd SEO-advies te werken.
Jarenlang werd aangeraden om FAQ-secties bijna standaard van FAQPage-structured data te voorzien omdat Google vragen en antwoorden uitgebreid in de zoekresultaten kon weergeven.
Dat landschap is veranderd.
Google beperkt de zichtbaarheid van FAQ-rich results sterk en geeft aan dat deze voornamelijk beschikbaar zijn voor bekende, gezaghebbende websites binnen overheid en gezondheid.
Dat betekent niet dat een FAQ op je website plots geen waarde meer heeft.
Integendeel: een goede FAQ kan bezoekers snel antwoord geven, relevante onderwerpen behandelen en een pagina inhoudelijk completer maken.
Maar FAQ-schema toevoegen puur omdat je verwacht daarmee extra ruimte in Google in te nemen, is voor een doorsnee bedrijfswebsite geen sterke strategie meer.
Dit illustreert meteen waarom structured data onderhouden moet worden: zoekmachines veranderen regelmatig welke markup ze daadwerkelijk voor zoekfuncties gebruiken.
En wat betekent Schema.org voor AI-vindbaarheid?
Hier wordt het bijzonder interessant.
Zoekmachines zijn niet langer de enige systemen die informatie op websites proberen te interpreteren. AI-zoekmachines, assistenten en andere systemen proberen eveneens te begrijpen welke bedrijven, personen, producten, diensten en onderwerpen op het web beschreven worden.
Structured data is daarbij aantrekkelijk omdat informatie expliciet en machineleesbaar wordt gemaakt.
Maar ook hier moeten we voorzichtig zijn met grote claims.
Er is geen universele regel die zegt dat het toevoegen van Schema.org ervoor zorgt dat ChatGPT, Google AI Overviews of andere AI-systemen jouw bedrijf vaker zullen noemen.
Structured data is dus geen gegarandeerde snelweg naar AI-zichtbaarheid.
Wel past het principe uitstekend binnen een bredere aanpak rond SEO en AI-vindbaarheid: zorg dat belangrijke informatie over je organisatie, diensten, auteurs en content duidelijk, consistent en technisch begrijpelijk wordt aangeboden.
Schema.org kan daar één onderdeel van zijn.
Structured data is overigens niet de enige manier waarop informatie specifiek voor machines gestructureerd kan worden aangeboden. Een recenter initiatief is llms.txt, een voorgestelde standaard die AI-agents naar belangrijke informatie en bronnen op een website kan leiden. Beide hebben een andere functie: Schema.org beschrijft de betekenis van gegevens op een pagina, terwijl llms.txt vooral als gecureerde toegangspoort tot informatie bedoeld is.

Meer Schema.org is niet automatisch beter
Wanneer mensen structured data ontdekken, ontstaat soms de neiging om zoveel mogelijk schema’s toe te voegen.
Dat is niet het doel.
Structured data moet beschrijven wat daadwerkelijk op je website aanwezig is.
Een dienst wordt geen product omdat je graag Product-schema wilt gebruiken. Een verzameling testimonials mag je niet zomaar omvormen tot structured data met fantastische ratings wanneer die markup niet aan de relevante richtlijnen voldoet.
Hetzelfde geldt voor informatie die niet zichtbaar of controleerbaar op de pagina aanwezig is.
Een goede implementatie is daarom eerder correct en doelgericht dan zo uitgebreid mogelijk.
Gebruik het meest specifieke type dat werkelijk bij de content past, vul relevante eigenschappen in en zorg ervoor dat de gegevens overeenkomen met de informatie die bezoekers zien.
Hoe voeg je Schema.org toe aan WordPress?
Wie WordPress gebruikt, hoeft niet noodzakelijk iedere regel JSON-LD zelf te schrijven.
SEO-plugins en andere gespecialiseerde plugins kunnen automatisch bepaalde structured data genereren voor onder andere websites, organisaties, personen, artikels en breadcrumbs.
Dat is handig, maar automatisering betekent niet dat je er niet meer naar hoeft te kijken.
Controleer bijvoorbeeld of de plugin de juiste organisatiegegevens gebruikt, of auteurs correct worden aangeduid en welk type aan verschillende pagina’s wordt toegekend.
Bij complexere websites kan daarnaast aangepaste structured data nodig zijn.
Let vooral op wanneer meerdere plugins tegelijk Schema.org genereren. Twee plugins kunnen dezelfde organisatie, breadcrumbs of andere informatie ieder op hun eigen manier toevoegen. Dat hoeft technisch niet altijd fout te zijn, maar kan wel tot onnodige of tegenstrijdige markup leiden.
Hoe controleer je structured data?
Na implementatie moet je structured data testen.
Daarvoor zijn twee tools bijzonder nuttig.
Google Rich Results Test
Met de Rich Results Test van Google kun je controleren of Google ondersteunde structured data op een pagina detecteert en of er problemen zijn die de geschiktheid voor rich results beïnvloeden.
De tool is vooral interessant wanneer je markup gebruikt waarvoor Google een specifieke zoekfunctie ondersteunt.
Schema.org Validator
Daarnaast bestaat de Schema.org Validator.
Deze kijkt breder naar Schema.org-markup en is daardoor ook nuttig voor types en eigenschappen die niet noodzakelijk gekoppeld zijn aan een Google rich result.
Het verschil is belangrijk.
Een Schema.org-implementatie kan technisch geldig zijn zonder dat Google daar een speciaal zoekresultaat voor aanbiedt.

Schema.org is geen SEO-truc, maar een extra informatielaag
Structured data is op zijn best wanneer je het niet als truc behandelt.
Een zoekmachine probeert te begrijpen wat je website vertelt. Schema.org geeft je een gestandaardiseerde manier om een deel van die betekenis expliciet te maken.
Je kunt aangeven dat iets een organisatie is, dat een bepaalde persoon een artikel geschreven heeft, dat een pagina een product beschrijft of dat een reeks links een breadcrumb vormt.
Dat kan zoekmachines helpen om informatie beter te interpreteren en kan voor ondersteunde contenttypes bijdragen aan uitgebreidere zoekresultaten.
Tegelijk vervangt Schema.org geen sterke content, goede websitestructuur of technische SEO.
Bij The Other Concept bekijken we structured data daarom als onderdeel van een bredere aanpak rond SEO en AI-vindbaarheid. Niet zoveel mogelijk markup toevoegen, maar de juiste informatie op een technisch correcte en begrijpelijke manier aanbieden.
Want uiteindelijk draait Schema.org om iets heel eenvoudigs: machines duidelijker vertellen wat mensen op je website vanzelf begrijpen.
Laatst bijgewerkt op 29 september 2026.
Gerelateerde artikelen



ChatGPT en SEO: de belangrijkste vragen beantwoord
ChatGPT en SEO zijn ondertussen nauw met elkaar verweven. SEO-specialisten gebruiken generatieve AI voor onderzoek, content, analyses en ideeën, terwijl mensen ChatGPT zelf steeds vaker gebruiken om informatie, bedrijven, producten en diensten te vinden.
Dat roept heel wat vragen op. Mag je teksten van ChatGPT gebruiken op je website? Kan Google AI-content herkennen? Heeft ChatGPT toegang tot Google? Kun je optimaliseren voor ChatGPT? En maakt AI traditionele SEO uiteindelijk overbodig?
In deze FAQ beantwoorden we de belangrijkste vragen over ChatGPT en SEO, met de nodige nuance.
Kan je ChatGPT gebruiken voor SEO?
Ja. ChatGPT kan bij heel wat onderdelen van SEO als hulpmiddel worden gebruikt.
Denk bijvoorbeeld aan het verzamelen en structureren van ideeën, het analyseren van zoekintenties, het opstellen van contentstructuren, het bedenken van mogelijke zoektermen, het herschrijven van teksten, het genereren van structured data of het analyseren van gegevens die je zelf aanlevert.
Dat betekent niet dat je iedere output rechtstreeks moet gebruiken.
ChatGPT kan informatie verkeerd interpreteren, verouderde of onjuiste informatie geven en overtuigend klinkende antwoorden formuleren die feitelijk niet kloppen. Bovendien kent het zonder bijkomende context jouw bedrijf, klanten en expertise niet zoals jij die kent.
Zie ChatGPT daarom eerder als een assistent binnen je SEO-proces dan als vervanging van strategie, expertise en controle.
Wil je concrete toepassingen zien? In ChatGPT voor SEO: voorbeelden en use cases laten we zien voor welke SEO-taken je ChatGPT praktisch kunt inzetten.
Is AI-gegenereerde content slecht voor SEO?
Niet automatisch.
Google maakt geen fundamenteel onderscheid tussen content omdat die door een mens of met behulp van AI werd gemaakt. De kwaliteit en het doel van de content zijn belangrijker dan de productiemethode.
Google geeft in zijn richtlijnen over generatieve AI-content aan dat generatieve AI nuttig kan zijn voor bijvoorbeeld onderzoek en het structureren van originele content.
Het probleem ontstaat wanneer AI wordt gebruikt om op grote schaal pagina’s te produceren zonder voldoende toegevoegde waarde. Dergelijke praktijken kunnen onder Google’s beleid rond scaled content abuse vallen.
Een door ChatGPT ondersteunde tekst kan dus prima presteren wanneer hij nuttig, betrouwbaar en origineel is. Honderden oppervlakkige pagina’s genereren puur om zoveel mogelijk zoektermen af te dekken is iets heel anders.
Straft Google teksten die met ChatGPT geschreven zijn?
Niet simpelweg omdat ChatGPT gebruikt werd.
Google heeft expliciet aangegeven dat gepast gebruik van AI of automatisering niet in strijd is met zijn richtlijnen. Automatisering gebruiken met als hoofddoel zoekresultaten manipuleren is dat wel.
Het idee dat iedere tekst die door ChatGPT werd aangeraakt automatisch een penalty krijgt, klopt dus niet.
De relevante vraag is niet:
Heeft AI deze tekst geschreven?
maar eerder:
Heeft deze pagina voldoende waarde voor de persoon die erop terechtkomt?
Google legt daarbij sterk de nadruk op helpful, reliable, people-first content.
Kan Google herkennen dat een tekst door ChatGPT geschreven is?
Proberen vast te stellen of Google een specifieke tekst als ChatGPT-tekst kan herkennen, is voor SEO eigenlijk de verkeerde discussie.
Google gebruikt allerlei systemen om kwaliteit, relevantie en spam te beoordelen, maar publiceert geen betrouwbare methode waarmee je kunt bepalen of een bepaalde pagina als AI-geschreven wordt geclassificeerd.
Daarom heeft het weinig zin om teksten door zogenaamde AI detectors te halen met als doel ze veilig voor Google te maken.
Concentreer je liever op de inhoud zelf.
Is de informatie correct? Voegt ze iets toe? Is ze gebaseerd op echte kennis of ervaring? Beantwoordt ze de vraag beter dan de tientallen vergelijkbare pagina’s die al bestaan?
Dat zijn veel nuttigere vragen.
Moet je vermelden dat je ChatGPT hebt gebruikt?
Niet bij iedere kleine toepassing.
Wanneer je ChatGPT gebruikt om bijvoorbeeld een titel te brainstormen, spelling te controleren of een bestaande alinea duidelijker te formuleren, is een uitgebreide AI-disclaimer meestal weinig zinvol.
Google adviseert wel transparantie wanneer lezers redelijkerwijs zouden willen weten hoe bepaalde content tot stand kwam.
Dat wordt relevanter wanneer AI een substantieel deel van de content genereerde of wanneer de manier waarop de informatie geproduceerd werd belangrijk is om de betrouwbaarheid ervan te beoordelen.
Transparantie moet dus vooral nuttig zijn voor de lezer, niet een truc om zoekmachines tevreden te stellen.
Kan ChatGPT zoekwoordenonderzoek doen?
Ja, maar met een belangrijke beperking.
ChatGPT is goed in taal. Daardoor kan het uitstekend helpen om onderwerpen te groeperen, synoniemen te vinden, long-tailvarianten te bedenken, mogelijke vragen te verzamelen en zoekintenties te onderzoeken.
Maar wanneer ChatGPT zegt dat een bepaald zoekwoord bijvoorbeeld 2.400 keer per maand gezocht wordt, moet je weten waar dat cijfer vandaan komt.
Zonder toegang tot een betrouwbare actuele databron moet je dergelijke zoekvolumes niet zomaar als feit aannemen.
Gebruik ChatGPT daarom bijvoorbeeld om van een lijst bestaande zoekwoorden logische clusters te maken of om nieuwe invalshoeken te vinden. Gebruik voor actuele zoekvolumes en prestaties daarvoor geschikte databronnen zoals Google Search Console, Google Keyword Planner of gespecialiseerde SEO-tools.
Kan ChatGPT mijn SEO-content schrijven?
Technisch gezien wel.
Maar simpelweg vragen Schrijf een SEO-blog van 1.000 woorden over zonnepanelen levert zelden content op waarmee je je echt onderscheidt.
ChatGPT weet immers niet automatisch welke ervaring jouw bedrijf heeft, welke vragen klanten daadwerkelijk stellen, welke cases je kunt tonen of welke mening je over een onderwerp hebt.
Juist die informatie kan een pagina waardevol maken.
Een interessantere workflow is daarom om zelf expertise, voorbeelden, bronnen, doelgroep en doel van de pagina aan te leveren en AI vervolgens te gebruiken om die informatie te structureren of verder uit te werken.
Daarna blijft menselijke redactie belangrijk.
Controleer feiten, verwijder algemeenheden, voeg eigen ervaring toe en vraag jezelf af of de tekst iets bevat dat niet op honderd andere websites staat.
Kan ChatGPT meta titles en meta descriptions schrijven?
Zeker.
Dit is zelfs een toepassing waarvoor ChatGPT bijzonder handig kan zijn.
Je kunt bijvoorbeeld de inhoud van een pagina aanleveren en verschillende SEO-titels en meta descriptions laten voorstellen binnen een bepaalde lengte en tone of voice.
Ook hier blijft controle nodig.
Een goede SEO-titel moet aansluiten bij de inhoud en zoekintentie. Een meta description moet aantrekkelijk zijn zonder dingen te beloven die niet op de pagina staan.
Bovendien bepaalt Google uiteindelijk zelf welke title link en snippet in de zoekresultaten wordt weergegeven. Je ingestelde SEO-titel en meta description zijn dus belangrijke input, maar geen garantie dat Google ze letterlijk overneemt.

Kan ChatGPT technische SEO uitvoeren?
ChatGPT kan uitstekend helpen bij technische SEO, maar kan zonder toegang tot je website en relevante data niet zelfstandig weten welke technische problemen er daadwerkelijk aanwezig zijn.
Je kunt het bijvoorbeeld vragen om een robots.txt-bestand te beoordelen, redirects te controleren, structured data op te stellen, HTML te analyseren of mogelijke oorzaken van een technisch probleem uit te leggen.
Daarmee wordt technische kennis sneller toegankelijk.
Maar een gegenereerde oplossing moet nog altijd getest worden. Een foutieve canonical, redirectregel of `noindex`-implementatie kan grote gevolgen hebben voor de vindbaarheid van een website.
Gebruik AI hier dus als technische assistent, niet als reden om wijzigingen blindelings door te voeren.
Kan ChatGPT interne links voorstellen?
Ja, en dit is een interessante toepassing wanneer ChatGPT voldoende informatie over je website krijgt.
Als je een overzicht van bestaande pagina’s en artikels aanlevert, kan het inhoudelijke verbanden herkennen en voorstellen waar een interne link relevant zou zijn.
Interne links helpen bezoekers om gerelateerde informatie te vinden en helpen zoekmachines om pagina’s te ontdekken en de onderlinge samenhang van je website beter te begrijpen.
De link moet wel logisch zijn voor de lezer. Overal geforceerd zoekwoorden als anchor tekst toevoegen omdat ze SEO-waarde zouden hebben, maakt content niet beter.
Meer hierover lees je in ons artikel over interne links.
Kan ChatGPT actuele zoekresultaten analyseren?
Dat hangt af van de gebruikte functies en beschikbare toegang.
Het klassieke beeld dat ChatGPT uitsluitend antwoorden geeft vanuit vooraf aangeleerde trainingsdata is niet meer volledig. ChatGPT kan in ondersteunde situaties het web doorzoeken en actuele bronnen gebruiken.
Dat betekent echter niet dat iedere reactie automatisch gebaseerd is op een volledige analyse van de actuele Google-resultaten.
Wanneer actuele SERP-data belangrijk is, moet duidelijk zijn welke bronnen daadwerkelijk werden geraadpleegd en welke gegevens je zelf hebt aangeleverd.
Hetzelfde geldt voor SEO-tools: toegang tot actuele informatie maakt de analyse mogelijk, maar maakt de conclusie niet automatisch correct.
Heeft ChatGPT toegang tot Google?
ChatGPT en Google zijn afzonderlijke systemen.
ChatGPT kan via web search actuele informatie op internet zoeken, maar dat betekent niet dat het onbeperkte interne toegang heeft tot Google’s zoekindex, rankingalgoritmen, Search Console-gegevens of Google Analytics van een website.
Je persoonlijke Search Console- of Analytics-data is ook niet zomaar beschikbaar omdat je er een vraag over stelt.
Voor SEO is dat onderscheid belangrijk. Een AI-model kan helpen informatie te interpreteren, maar je moet weten welke gegevens het daadwerkelijk tot zijn beschikking heeft.
Kunnen mensen mijn website vinden via ChatGPT?
Ja.
ChatGPT kan bij zoekvragen informatie van websites gebruiken en links naar bronnen tonen. Daardoor ontstaat naast klassieke zoekmachines een extra manier waarop mensen websites, bedrijven en informatie kunnen ontdekken.
OpenAI geeft in zijn richtlijnen voor publishers en developers aan dat openbare websites in ChatGPT Search kunnen verschijnen.
Wil je dat content kan worden opgenomen in samenvattingen en fragmenten, dan is het onder andere belangrijk dat OAI-SearchBot niet wordt geblokkeerd.
Dat betekent overigens niet dat iedere crawlbare website automatisch als bron wordt gebruikt. Net zoals bij Google blijft daadwerkelijke zichtbaarheid afhankelijk van de vraag, beschikbare bronnen en de systemen die bepalen welke informatie relevant is.
Moet ik mijn website optimaliseren voor ChatGPT?
Het is zinvol om rekening te houden met vindbaarheid buiten de klassieke lijst met blauwe Google-links, maar dat betekent niet dat je ineens al je SEO-werk moet vervangen door een volledig aparte strategie.
Veel principes overlappen.
Maak informatie toegankelijk. Zorg voor duidelijke pagina’s. Gebruik begrijpelijke taal. Bouw inhoudelijke samenhang op met interne links. Publiceer vooral originele informatie en echte expertise. Dat laatste kan zelfs belangrijker worden naarmate steeds meer online content met AI wordt geproduceerd. In als AI het internet schrijft, waar haalt AI straks zijn kennis vandaan? bekijken we wat er kan gebeuren wanneer AI-content opnieuw als informatiebron voor andere systemen gaat dienen.
Zorg daarnaast dat technische crawlers je content kunnen bereiken wanneer je opgenomen wilt worden.
Daar komt voor ChatGPT specifiek bij dat OpenAI aparte crawlers gebruikt en website-eigenaars via `robots.txt` controle kunnen uitoefenen over bepaalde vormen van toegang.
Hoe ChatGPT de manier waarop we over SEO en online vindbaarheid denken verandert, bespreken we uitgebreider in wat ChatGPT kan betekenen voor SEO.
Wat is het verschil tussen SEO, AEO en GEO?
SEO staat voor Search Engine Optimization en richt zich op vindbaarheid via zoekmachines.
Daarnaast kom je steeds vaker termen tegen zoals AEO (Answer Engine Optimization) en GEO (Generative Engine Optimization). Daarmee wordt meestal bedoeld dat content ook geschikt wordt gemaakt om gevonden, begrepen of aangehaald te worden binnen antwoordmachines en generatieve AI-systemen.
Het is verleidelijk om dit als compleet nieuwe disciplines te presenteren.
In werkelijkheid is er veel overlap met goede SEO: technisch toegankelijke content, duidelijke antwoorden, betrouwbare informatie, logische structuur, relevante links en aantoonbare expertise blijven belangrijk.
Google waarschuwt zelf inmiddels voor verschillende mythes rond zogenaamde AEO/GEO-optimalisatie en stelt dat zijn bestaande SEO-principes ook de basis vormen voor zichtbaarheid in AI Overviews en AI Mode.
Nieuwe zoekervaringen veranderen dus wel waar mensen informatie vinden, maar veel fundamenten van goede online vindbaarheid blijven overeind.
Kan je optimaliseren voor Google AI Overviews en AI Mode?
Ja, maar niet door een verborgen AI-truc toe te passen.
Google zegt expliciet dat er geen speciale technische vereisten zijn om als ondersteunende link in AI Overviews of AI Mode te verschijnen. Een pagina moet geïndexeerd zijn, in aanmerking komen om met een snippet in Google Search te verschijnen en voldoen aan de normale technische vereisten.
Google adviseert onder andere:
- originele en waardevolle content voor bezoekers te maken;
- ervoor te zorgen dat belangrijke informatie als tekst beschikbaar is;
- pagina’s goed bereikbaar te maken via interne links;
- een goede gebruikerservaring te bieden;
- relevante afbeeldingen en video’s te gebruiken waar die iets toevoegen;
- structured data te laten overeenkomen met de zichtbare inhoud.
Er bestaat volgens Google geen speciale schema markup of apart AI-bestand dat je moet toevoegen om in AI Overviews of AI Mode te verschijnen.
Dat is belangrijk, want rond AI-vindbaarheid ontstaan momenteel ook veel technieken en claims waarvoor weinig bewijs bestaat.
Is structured data belangrijk voor ChatGPT en AI-zoekmachines?
Structured data blijft nuttig omdat het machines extra gestructureerde informatie over een pagina kan geven, maar je moet er geen magische AI-optimalisatie van maken.
Voor Google kan ondersteunde structured data bepaalde zoekresultaatfuncties mogelijk maken en helpt ze Google de inhoud van een pagina beter te begrijpen. De markup moet daarbij overeenkomen met wat bezoekers daadwerkelijk op de pagina kunnen zien.
Google zegt tegelijkertijd expliciet dat er geen speciale structured data voor AI Overviews of AI Mode nodig is.
Voor ChatGPT bestaat evenmin een universele schema-code waarmee je afdwingt dat je website als bron wordt gebruikt.
Gebruik structured data dus waarvoor ze bedoeld is, niet als truc om AI-systemen te manipuleren.
Moet ik een llms.txt-bestand toevoegen voor AI-vindbaarheid?
Je komt steeds vaker adviezen tegen om een llms.txt-bestand aan je website toe te voegen.
Op dit moment moet je daar voorzichtig mee omgaan.
Het formaat kan in bepaalde technische contexten interessant zijn, maar het is geen universele standaard waarmee je automatisch beter zichtbaar wordt in ChatGPT, Google AI Overviews of andere generatieve zoekervaringen.
Google zegt expliciet dat je geen nieuwe machine-readable bestanden of AI-tekstbestanden hoeft aan te maken om in zijn AI-features te verschijnen.
Voor ChatGPT is vooral relevant dat de juiste crawler toegang heeft tot openbare content wanneer je gevonden wilt kunnen worden.
Een llms.txt toevoegen puur omdat iemand belooft dat je daardoor hoger scoort in AI zouden we daarom niet als SEO-strategie beschouwen.
Vervangt ChatGPT Google?
Dat is geen bijzonder nuttige tegenstelling.
Mensen kunnen Google gebruiken voor een snelle zoekopdracht, ChatGPT om een complex onderwerp te onderzoeken, Google Maps om een lokaal bedrijf te vinden, YouTube voor een tutorial en vervolgens rechtstreeks een bedrijfswebsite bezoeken.
Bovendien verwerkt Google zelf generatieve AI steeds dieper in Search via onder andere AI Overviews en AI Mode.
De zoekervaring verandert dus eerder dan dat alle zoekopdrachten plots naar één platform verhuizen.
Voor bedrijven betekent dit dat online vindbaarheid breder wordt dan alleen een positie in tien klassieke zoekresultaten.
Is traditionele SEO nog relevant door ChatGPT en AI?
Ja.
Technische toegankelijkheid, kwalitatieve content, interne links, autoriteit, een duidelijke websitestructuur en begrijpen waar je doelgroep naar zoekt blijven belangrijk.
Google benadrukt dit zelf in zijn richtlijnen voor generatieve AI-features: bestaande SEO-best practices blijven de basis.
Wat wel verandert, is de context waarin die informatie gevonden wordt.
Een gebruiker hoeft niet altijd meer een zoekterm in te voeren, tien resultaten te bekijken en vervolgens één website te openen. Een AI-systeem kan verschillende bronnen combineren tot een antwoord en daarbij links aanbieden om verder te lezen.
Dat maakt onderscheidende content juist belangrijker.
Wanneer je pagina weinig meer bevat dan informatie die op honderden andere websites staat, is er weinig reden om specifiek jouw pagina als waardevolle bron te beschouwen.
Eigen onderzoek, praktijkervaring, duidelijke voorbeelden, originele beelden, cases en inhoudelijke expertise worden daardoor interessanter.
Gaat ChatGPT SEO-specialisten vervangen?
ChatGPT kan steeds meer taken uitvoeren die vroeger veel handmatig werk vroegen.
Dat verandert het werk van een SEO-specialist.
Een zoekwoordenlijst categoriseren, regex schrijven, contentstructuren maken, data interpreteren of eerste tekstversies uitwerken kan aanzienlijk sneller.
Maar SEO bestaat niet alleen uit het uitvoeren van losse taken.
Welke pagina moet je maken? Welke hoeft juist niet gemaakt te worden? Waarom daalt organisch verkeer? Welke zoekintentie is commercieel interessant? Welke technische fout heeft prioriteit? Hoe verhoudt SEO zich tot branding, UX en conversie?
AI kan bij die vragen helpen, maar iemand moet nog altijd context geven, resultaten beoordelen en beslissingen nemen.
Waarschijnlijk verdwijnt SEO daarom niet. De manier waarop we SEO uitvoeren verandert wel.
Hoe gebruiken wij ChatGPT voor SEO?
Bij The Other Concept zien we ChatGPT vooral als een hulpmiddel om bepaalde onderdelen van SEO sneller te onderzoeken, analyseren en uitwerken.
We kunnen bijvoorbeeld ideeën groeperen, mogelijke contentstructuren onderzoeken, teksten kritisch laten bekijken, technische vraagstukken analyseren of bestaande informatie op een andere manier structureren.
Maar de interessante stap komt daarna.
Klopt de informatie? Past ze bij het bedrijf? Is de tekst onderscheidend genoeg? Kunnen we eigen ervaring toevoegen? Zijn bronnen actueel? Bestaat er intern al content waarnaar we kunnen verwijzen? En helpt deze pagina daadwerkelijk iemand verder?
Die menselijke controle maakt het verschil tussen AI gebruiken om sneller content te produceren en AI gebruiken om beter te werken.
Wil je vooral praktische voorbeelden bekijken, dan vind je die in onze voorbeelden en use cases voor ChatGPT en SEO. Voor de bredere invloed van generatieve AI op zoeken en online vindbaarheid lees je verder in wat ChatGPT kan betekenen voor SEO.
ChatGPT verandert SEO, maar de basis blijft herkenbaar
ChatGPT heeft SEO niet overbodig gemaakt.
Het heeft wel twee grote veranderingen veroorzaakt.
Aan de ene kant beschikken marketeers, copywriters, developers en SEO-specialisten over een krachtige assistent waarmee veel werkzaamheden sneller kunnen verlopen.
Aan de andere kant verandert generatieve AI de manier waarop mensen informatie zoeken en websites ontdekken.
Daardoor moeten bedrijven breder naar vindbaarheid kijken.
Niet alleen: Op welke positie staan we in Google?
Maar ook: Is onze informatie betrouwbaar, toegankelijk, onderscheidend en bruikbaar genoeg om gevonden en gebruikt te worden, ongeacht hoe iemand zoekt?
Dat is uiteindelijk geen afscheid van SEO.
Het is een uitbreiding ervan.
Laatst aangepast: 23 september 2026.
Gerelateerde artikelen


SEO vs. SEA: wat is het verschil en wanneer kies je wat?
Wanneer je beter gevonden wilt worden in Google, kom je al snel twee termen tegen: SEO en SEA.
Beide hebben als doel om je onderneming zichtbaar te maken wanneer potentiële klanten zoeken naar je producten, diensten of informatie. De manier waarop ze dat doen is echter fundamenteel verschillend.
Met SEO probeer je je zichtbaarheid in de organische zoekresultaten te verbeteren. Met SEA betaal je om advertenties te tonen bij relevante zoekopdrachten.
Maar wat is nu precies het verschil tussen SEO en SEA? Wat kost het? Hoe snel zie je resultaat? En misschien nog belangrijker: moet je eigenlijk wel kiezen tussen beide?
Wat is SEO?
SEO staat voor Search Engine Optimization, of zoekmachineoptimalisatie.
Het omvat alle inspanningen waarmee je probeert een website beter vindbaar te maken in de organische resultaten van zoekmachines zoals Google.
Wanneer iemand bijvoorbeeld zoekt naar webdesign Herselt, bepaalt Google welke pagina’s volgens zijn systemen het meest relevant en bruikbaar zijn voor die zoekopdracht.
Je kunt Google niet betalen om een organische pagina hoger te plaatsen.
Dat betekent echter niet dat SEO gratis is.
Goede SEO vraagt tijd en expertise. Je moet onder andere nadenken over zoekintentie, content, websitestructuur, interne links, techniek, gebruikservaring en autoriteit.
Google geeft zelf een uitgebreid overzicht van de basis in zijn SEO Starter Guide.
Het voordeel is dat je daarmee iets opbouwt.
Een sterk kennisartikel of een goed geoptimaliseerde dienstenpagina kan maanden of zelfs jaren organisch bezoekers blijven aantrekken zonder dat je voor iedere klik aan Google betaalt.
Wil je de basis uitgebreider bekijken? In Hoger scoren in Google: 12 SEO-principes bespreken we de belangrijkste onderdelen van een duurzame SEO-strategie.
Wat is SEA?
SEA staat voor Search Engine Advertising: adverteren binnen zoekmachines.
Bij Google gebeurt dat via Google Ads.
Je maakt campagnes waarmee advertenties kunnen verschijnen wanneer iemand een relevante zoekopdracht uitvoert. Afhankelijk van je campagne bepaal je onder andere welke zoekopdrachten, locaties en doelgroepen relevant zijn en welk budget je wilt besteden.
Google bepaalt vervolgens via een advertentieveiling welke advertenties in aanmerking komen en waar ze verschijnen.
Daarbij draait het niet uitsluitend om wie het meeste betaalt. Google gebruikt Ad Rank, waarbij onder andere biedingen, relevantie en verschillende andere signalen een rol spelen.
Google legt zelf uit hoe dit proces werkt in de uitleg over Google Ads en de advertentieveiling.
Bij Search-campagnes betaal je doorgaans wanneer iemand daadwerkelijk op je advertentie klikt. Dat noemen we CPC: cost per click.
Stop je met adverteren, dan verdwijnt ook die betaalde zichtbaarheid.
Waar zie je SEO en SEA in Google?
Bij een zoekopdracht kunnen advertenties en organische zoekresultaten op dezelfde resultatenpagina verschijnen.
Betaalde resultaten worden door Google als advertenties aangeduid. De organische resultaten staan daar los van.
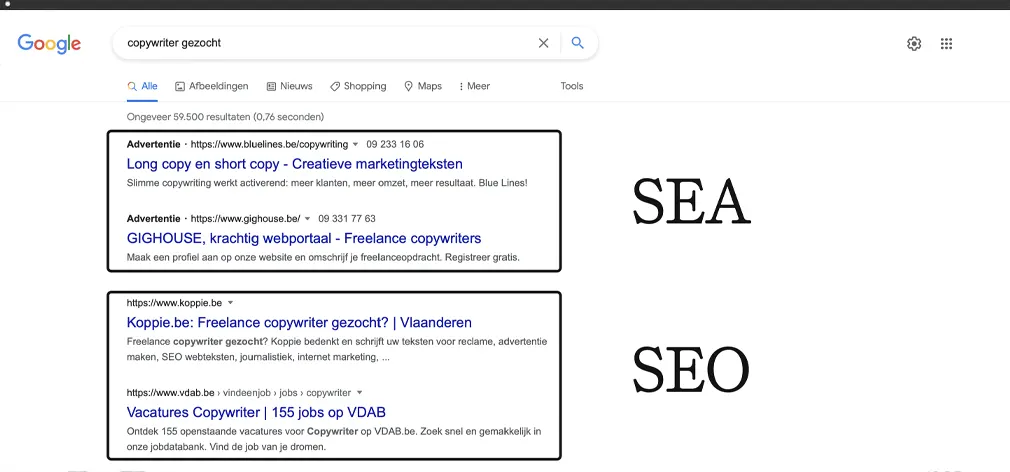
Google benadrukt zelf dat zijn organische zoekresultaten onafhankelijk zijn van zijn advertentieprogramma’s. Geld uitgeven aan Google Ads zorgt er dus niet voor dat je organische website daardoor hoger gaat scoren.
De precieze zoekresultatenpagina ziet er bovendien niet bij iedere zoekopdracht hetzelfde uit.
Naast traditionele links en advertenties kan Google bijvoorbeeld afbeeldingen, video’s, lokale resultaten, shoppingresultaten, featured snippets en AI-functionaliteit tonen.
SEO gaat daardoor vandaag om meer dan alleen proberen de eerste blauwe link te worden.
Wat is het belangrijkste verschil tussen SEO en SEA?
Het fundamentele verschil zit in hoe je zichtbaarheid verkrijgt.
Bij SEA koop je advertentieruimte. Zolang je campagnes actief zijn en voldoende budget hebben, kunnen je advertenties worden weergegeven bij relevante zoekopdrachten.
Bij SEO bouw je organische zichtbaarheid op door je website en content zo sterk mogelijk te maken voor relevante zoekopdrachten.
Dat verschil heeft gevolgen voor snelheid, kosten, controle en duurzaamheid.
| SEO | SEA | |
|---|---|---|
| Zichtbaarheid | Organische zoekresultaten | Betaalde advertenties |
| Betalen per klik | Nee | Doorgaans wel bij Search Ads |
| Snel resultaat mogelijk | Meestal niet | Ja |
| Resultaat na stoppen | Kan blijven bestaan | Betaalde zichtbaarheid stopt |
| Controle | Beperkter | Veel controle over campagnes |
| Langetermijnwaarde | Kan sterk opbouwen | Afhankelijk van blijvende investering |
Die verschillen betekenen niet dat de ene methode beter is dan de andere.
Ze maken SEO en SEA juist interessant voor verschillende doelen en momenten.
SEA kan veel sneller zichtbaarheid opleveren
Een van de grootste voordelen van SEA is snelheid.
Een nieuwe website heeft meestal niet onmiddellijk sterke organische posities. Met Google Ads kun je veel sneller zichtbaar worden voor relevante zoekopdrachten.
Dat kan interessant zijn bij bijvoorbeeld een nieuwe dienst, tijdelijke actie, evenement of campagne.
Je hebt bovendien veel controle.
Je kunt budgetten bepalen, geografisch targeten, campagnes tijdelijk stoppen en analyseren welke zoekopdrachten tot klikken en conversies leiden.
Google gebruikt tegenwoordig veel automatisering en machine learning binnen Search Ads. Ook keyword matching kijkt niet uitsluitend meer naar de letterlijke woorden die iemand intypt, maar kan onder andere betekenis en andere signalen gebruiken om relevante zoekopdrachten te koppelen.
Daarom vraagt SEA meer dan simpelweg enkele zoekwoorden invoeren en een dagbudget instellen.
Een goed ingerichte campagne moet opgevolgd en geoptimaliseerd worden.
SEO heeft tijd nodig, maar bouwt iets op
Bij SEO werkt het anders.
Een nieuwe pagina publiceren betekent niet dat je de volgende ochtend bovenaan Google staat.
Google moet de pagina kunnen ontdekken en verwerken en vervolgens bepalen hoe relevant die pagina is ten opzichte van andere beschikbare resultaten. Concurrentie speelt daarbij uiteraard ook een belangrijke rol.
SEO is daarom meestal een strategie voor de langere termijn.
Het interessante is dat je investeert in je eigen website en content.
Een goed artikel blijft bestaan wanneer je er morgen geen advertentiebudget meer tegenaan zet. Een verbeterde websitestructuur helpt ook andere pagina’s. Sterke interne links kunnen verschillende delen van de website ondersteunen.
Dat betekent niet dat rankings permanent zijn.
Concurrenten verbeteren hun websites, zoekgedrag verandert en Google past zijn systemen voortdurend aan. SEO vraagt dus eveneens opvolging.
Maar het opgebouwde werk verdwijnt niet onmiddellijk wanneer je even stopt met investeren.
Is SEO dan goedkoper dan SEA?
Niet noodzakelijk.
De uitspraak SEO is gratis en SEA kost geld is misleidend.
Voor een organische klik betaal je inderdaad geen bedrag aan Google. Maar iemand moet wel onderzoek doen, content schrijven, technische problemen oplossen, pagina’s verbeteren en resultaten opvolgen.
Dat kan je zelf doen of uitbesteden.
SEO heeft dus ook een kost.
Bij SEA is die kost alleen veel directer zichtbaar. Je hebt advertentiebudget en mogelijk kosten voor het beheren en optimaliseren van de campagnes.
Welke methode uiteindelijk goedkoper is per nieuwe klant hangt af van enorm veel factoren: concurrentie, marges, zoekvolume, conversieratio, kwaliteit van de website en de waarde van een klant.
Daarom zou ik SEO en SEA niet vergelijken op basis van “welke is goedkoper?”, maar eerder:
Welke investering helpt het best om mijn huidige doel te bereiken?
Wanneer is SEA interessant?
SEA wordt vooral interessant wanneer je relatief snel relevante bezoekers wilt bereiken en bereid bent daarvoor advertentiebudget te gebruiken.
Denk bijvoorbeeld aan:
- een nieuwe website die organisch nog weinig zichtbaarheid heeft;
- een tijdelijke campagne of promotie;
- een nieuwe dienst of productlancering;
- zoekopdrachten met een duidelijke commerciële intentie;
- het testen van verschillende aanbiedingen of landingspagina’s;
- markten waarin je heel gericht bepaalde regio’s of doelgroepen wilt bereiken.
Het grote voordeel is meetbaarheid.
Je kunt bijvoorbeeld zien welke campagnes, advertenties en zoekopdrachten klikken en conversies opleveren.
Maar daar hoort een belangrijke voorwaarde bij: de pagina waarop iemand terechtkomt moet goed zijn.
Advertentiebudget lost een slechte website niet op.
Wanneer bezoekers op je advertentie klikken maar vervolgens afhaken door een trage, onduidelijke of ongeloofwaardige landingspagina, betaal je uiteindelijk vooral om meer mensen naar een probleem te sturen.
Wanneer is SEO interessant?
SEO is vooral interessant wanneer er structureel gezocht wordt naar onderwerpen die relevant zijn voor je onderneming.
Dat kunnen commerciële zoekopdrachten zijn, maar ook vragen die potentiële klanten eerder in hun beslissingsproces stellen.
Een boekhouder kan bijvoorbeeld niet alleen gevonden worden op boekhouder Antwerpen, maar ook informatie publiceren over vragen die ondernemers regelmatig hebben.
Zo bouw je doorheen de tijd een bibliotheek van relevante pagina’s op.
SEO past daardoor goed bij bedrijven die duurzame organische zichtbaarheid willen opbouwen en bereid zijn daar consequent in te investeren.
Content alleen is daarbij niet voldoende.
Technische kwaliteit, mobiele bruikbaarheid, websitestructuur en interne links blijven eveneens belangrijk. Onze SEO-woordenlijst geeft een overzicht van veel begrippen die je daarbij tegenkomt.
SEO en SEA hoeven geen concurrenten te zijn
Dit is misschien wel het belangrijkste punt van het artikel.
Je hoeft niet noodzakelijk te kiezen.
SEO en SEA kunnen elkaar juist goed aanvullen.
Stel dat je een nieuwe dienstenpagina lanceert. Organisch kan het tijd kosten voordat die pagina zichtbaarheid opbouwt. Met SEA kun je ondertussen al gericht verkeer aantrekken.
De informatie uit advertentiecampagnes kan vervolgens inzichten geven in zoekgedrag en conversie. SEO-data kan omgekeerd interessante onderwerpen en zoekopdrachten blootleggen die ook voor advertenties relevant zijn.
Je kunt bovendien advertenties gebruiken voor strategisch belangrijke zoekopdrachten waarop je organisch nog niet sterk zichtbaar bent.
Het doel is uiteindelijk niet om zoveel mogelijk SEO of zoveel mogelijk SEA te doen.
Het doel is om op de juiste momenten zichtbaar te zijn voor de juiste mensen.
Vergeet de website achter SEO en SEA niet
Zowel SEO als SEA kunnen bezoekers naar je website brengen.
Daar stopt het werk niet.
Iemand moet vervolgens begrijpen wat je aanbiedt, vertrouwen krijgen en gemakkelijk een volgende stap kunnen zetten.
Daarom spelen webdesign, content en conversie bij beide kanalen een belangrijke rol.
Een goede advertentie met een slechte landingspagina kan geld verspillen. Een nummer-éénpositie in Google heeft weinig waarde wanneer bezoekers onmiddellijk terug vertrekken omdat ze niet vinden wat ze zoeken.
In waarom bezoekers je website verlaten bekijken we verschillende oorzaken waardoor een website verkeer wel aantrekt, maar bezoekers vervolgens opnieuw verliest.
En wanneer je wijzigingen aan belangrijke landingspagina’s wilt vergelijken, kan A/B-testing helpen om beslissingen met data te onderbouwen.
Wat kies je: SEO of SEA?
Dat hangt af van je doel.
Wil je op korte termijn een specifieke campagne zichtbaar maken? Dan kan SEA interessant zijn.
Wil je structureel organische zichtbaarheid opbouwen rond onderwerpen die belangrijk zijn voor je onderneming? Dan is SEO een logische investering.
In veel gevallen is de interessantste strategie echter geen keuze tussen beide.
SEA kan snel verkeer en data opleveren, terwijl SEO op langere termijn een sterkere organische basis opbouwt.
Bekijk daarom eerst waar je vandaag staat.
Voor welke zoekopdrachten ben je al zichtbaar? Waar liggen kansen? Welke zoektermen leveren daadwerkelijk klanten op? Hoe sterk zijn je landingspagina’s? En hoeveel tijd en budget kun je investeren?
SEO en SEA zijn twee verschillende manieren om dezelfde persoon te bereiken op het moment dat die actief naar iets zoekt.
De juiste verhouding tussen beide hangt af van je onderneming, markt en doelstellingen.
Laatst aangepast: 25 september 2026.